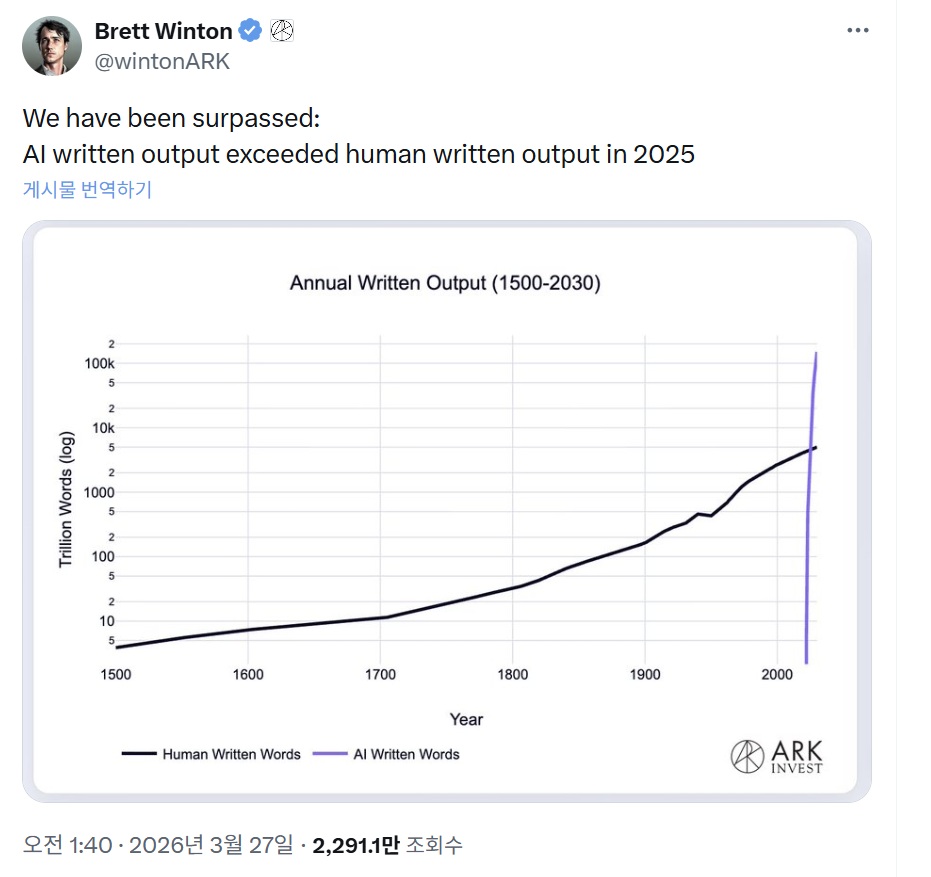
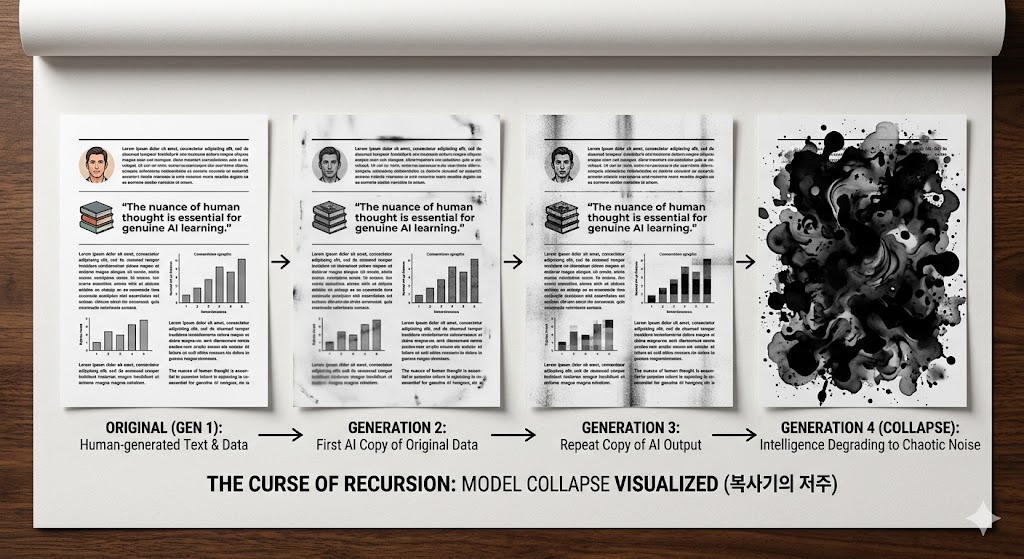
모두가 데이터의 종말을 경고하며 절망하고 있을 때, 일각에서 이는 기우에 불과하다는 주장이 제기됐습니다. 구글 수석과학자 제프 딘은 전혀 다른 의견을 내놓았는데요. 그는 최근 열린 엔비디아 GTC 2026 대담에서 “데이터가 고갈되고 있다는 주장에 동의하지 않는다”고 단언했습니다. 딘은 새로운 지능의 보고(寶庫)는 바로 ‘비디오와 현실 세계의 물리적 데이터’ 입니다.
텍스트는 인류가 가진 지식의 극히 일부에 불과합니다. 인류의 지식을 기록하는 방법이 텍스트만 있는 것은 아니기 때문이죠. 우리가 보고, 듣고, 만지며 느끼는 현실 세계의 정보량에 비하면 도서관의 장서들은 일부분을 요약한 ‘초록’에 가깝습니다. 딘은 AI가 아직 본격적으로 학습하지 않은 유튜브의 방대한 비디오 데이터, 그리고 로봇과 자율주행차가 현실에서 온몸으로 부딪히며 만들어내는 물리적 데이터가 텍스트와 비교할 수 없을만큼 거대한 금광이라고 강조했습니다.
“현실 세계의 로봇 공학이나 자율주행차에서 나오는 데이터들은 앞으로 꽤나 풍부해질 것입니다. 우리는 이미 비디오 데이터를 학습시키고있지만 아직 쓰지 않은 비디오와 그에 딸린 오디오 데이터가 훨씬 더 많이 남아있습니다.”
비디오가 텍스트보다 강력한 이유는 두 가지로 볼 수 있습니다.
첫째는 정보의 밀도입니다. 텍스트 데이터는 인간이 한 번 필터링한 추상적인 기호죠. 반면 비디오는 픽셀 하나 하나에 시간과 공간의 정보가 담겨 있습니다. 1초 분량의 영상에 담긴 데이터의 양은 수만 단어 텍스트보다 압도적으로 많습니다. 딘은 이를 두고 “우리는 아직 데이터의 1%도 쓰지 않았다”고 말하죠. 인류가 남긴 모든 활자를 다 읽었다해도 매 초 쏟아지는 전 세계의 영상 데이터에 비하면 그것은 간식 수준에 불과합니다.
구글 북스 통계에 따르면 인류 역사상 출판된 도서는 약 1억5000만권 정도로 추산됩니다. 책 한 권을 약 50만자 정도로 보면 그 용량은 대략 1MB 정도입니다. 즉 인류의 모든 지혜가 담긴 도서 데이터가 약 150TB 정도라는 의미죠. 우리에게 익숙한 유튜브라는 동영상 플랫폼엔 분당 약 500~1000시간 분량의 영상이 업로드되고 있습니다. 하루에만 약 72만~144만시간의 영상이 차곡차곡 쌓이고 있죠. HD급 영상 1시간이 약 2GB라고 할 때 유튜브엔 하루 약 1.5~3PB(페타바이트)의 데이터가 누적되는 중입니다.
둘째는 물리법칙의 습득입니다. 가령 중력에 대해 설명할 때 “사과가 아래로 떨어진다”고 글로 설명하는 것보다 사과 등 여러 물체가 낙하하는 장면을 보는 것, 이것이 AI에겐 훨씬 강력한 학습이 됩니다. 비디오를 통해 AI는 중력, 마찰력, 인과관계 같은 세상의 문법을 스스로 깨우치는 것입니다. 거대언어모델(LLM)이 인간의 말을 흉내내는데 집중했다면 비디오 세상에서 태어난 AI는 세상이 어떻게 돌아가는지 이해하는 모델로 진화하고 있는 것이죠.
피지컬AI의 도움으로 세상 밖으로 나온 AI는 텍스트를 벗어나 이런 고순도 데이터를 직접 찾아 나설 것입니다. 이제 AI의 지능은 멈춰있는 글이 아니라 생동하는 현실 세계 속에서 폭발적인 진화를 준비하고 있습니다.