State of AI Report 2023를 요약했습니다! # 12 위클리 딥 다이브 | 2023년 11월 1일
에디터 이지 |
|
|
💡이번주 뉴스레터에는 이런 내용을 담았어요!
- 2023년 AI 현황! State of AI Report 2023 보고서를 소개합니다.
- 방법론면에서 우세를 점하고 있는 RLHF, 가열되는 오픈소스 모델의 경쟁에 대해 설명합니다.
- 데이터가 소진되고 있는 현재의 실태와, 고품질 데이터의 새로운 가능성을 정리했습니다.
|
|
|
바쁘다 바빠, 현대사회 🏃♀️🏃♂️ 이런 상황을 모면하기 위해서는 긴장의 끈을 놓지 않고 매일 갱신되는 최신 뉴스에 신경을 곤두세워야 합니다🫥 얼리어답터는 고사하고 빠르게 바뀌는 트렌드를 따라가기도 바쁜데요 💨 이번 뉴스레터에서는 AI 현황 보고서 2023(State of AI Report 2023)에 소개된 AI에 관한 흥미로운 트렌드를 몇 가지 전해드리겠습니다. |
|
|
Created by. DALL-E 3
State of AI Report는 Nathan Benaich와 영국의 벤처 캐피탈 Air Street Capital 팀이 작성하여 업계 실무자들의 검토를 받아 6년째 작성되고 있는 AI 보고서입니다. 매년 10월 무렵 공개되는 이 보고서에는 AI의 현황을 알기 쉽게 요약하여 정리하여, 공개될 때마다 많은 이들에게 관심을 받고는 하는데요. State of AI Report 2023년 편은 총 163페이지에, 연구 / 산업 / 정치 / 안전 / 예측 총 다섯 부문으로 이루어져 있습니다.
이번주 뉴스레터에는 보고서에 소개된 주요 내용 중 일부를 담았습니다📁 |
|
|
RHLF Reinforced Learning from Human Feedback👨💻 |
|
|
2023년도는 생성형 AI, 그 중 특히 언어 모델의 해였습니다. 2023의 핫한❗️기술이라고 한다면 GPT-4와 환각현상을 개선하기 위해 도입된 RLHF(Reinforced Learning from Human Feedback)와 RBRM(Rule-Based Reward Model) 평가 방식 도입을 언급하지 않고는 넘어갈 수 없는데요.
RLHF에 대한 다양한 논란과 의문제기에도 불구하고 OpenAI는 RLHF과 RBRM의 도입을 통해 사람의 피드백을 통한 강화학습의 힘을 검증하였습니다. 이제는 흐름을 따라 Anthropic의 Claude, Google의 Bard, Meta의 LLaMA-2-chat 등 ChatGPT에서 활용된 RLHF 방법론에 따라 대부분의 LLM이 RLHF을 도입하고 있습니다. |
|
|
Created by. DALL-E 3
코피티션(Coopetition; Cooperation+Competition)이라는 키워드를 통해 알 수 있듯 4차 산업혁명에서 협력은 그 어느 때보다 중요해지고 있습니다. 새로운 발견이 쏟아져 나오는 시대에서 하나의 기업이 모든 분야의 지식과 기술을 독점할 수는 없기 때문입니다.
초기 언어모델의 개발은 '설명가능한 AI'(XAI; eXplainable AI)를 지향해 논문과 코드를 오픈했었습니다. 하지만 OpenAI를 포함한 다수 기업들이 이러한 흐름에 거스르는 동향을 보여 논쟁이 벌어지고 있습니다. 아래와 같이 OpenAI와 Google은 각각 GPT-4와 PaLM-2에 대한 기술보고서는 공개했지만 모델과 코드는 공개하지 않는다고 밝히고 있습니다. |
|
|
“GPT-4와 같은 대규모 모델의 경쟁 환경과 안전 영향을 모두 고려할 때 이 보 고서에는 아키텍처(모델 크기 포함), 하드웨어, 훈련 컴퓨팅, 데이터 세트 구성, 훈련 방법 등에 대한 추가 세부 정보가 포함되어 있지 않습니다”
_ GPT-4 Technical Report |
|
|
이와 같은 개방성 논쟁에서 OpenAI와 MetaAI의 입장은 대조적입니다. 초기 2023년 2월에 LLaMA가 출시되었을 때 Meta는 연구자에게만 언어 모델을 활용할 수 있는 엑세스 권한을 부여했었지만, 가중치가 온라인에 유출되면서 의도치 않게 언어 모델 오픈소스 움직임을 형성했습니다.
이러한 움직임에 동참한 기업으로는 mosaicML의 MPT-30B, TII UAE의 Falcon-40B, Together의 RedPajama 또는 Eleuther의 Pythia 등이 있습니다. 그러다 2023년 7월 LLaMA-2가 출시되면서 거의 모든 사람에게 상업적 사용 권한까지 부여되어 오픈소스의 대표주자로 자리잡게 되었습니다.
앞서 코피티션이라고 말씀드렸죠? 오픈소스 모델이라고 해서 경쟁이 없는 것은 아닙니다. 각자의 모델의 우수함을 선보이면서, 제법 경쟁적으로 모델들이 쏟아지고 있는데요. 위에서 언급한 모델들이 현재 여러분들에게 낯설 수 있지만 쟁쟁한 경쟁을 뚫고 선발된 몇 개의 모델들이니 관심 있으신 분들은 찾아보는 것도 좋을 것 같습니다. |
|
|
AI 커뮤니티는 언어 모델이 처리할 수 있는 컨텍스트 길이를 늘려 성능을 개선하고자 했지만 한계점이 있는 것으로 드러났습니다. 매개변수의 수를 증가시키는 방법 모두 높은 메모리 요구 사항 충족 등 아키텍처 관점에서도 추가적인 개선점이 필요했습니다. |
|
|
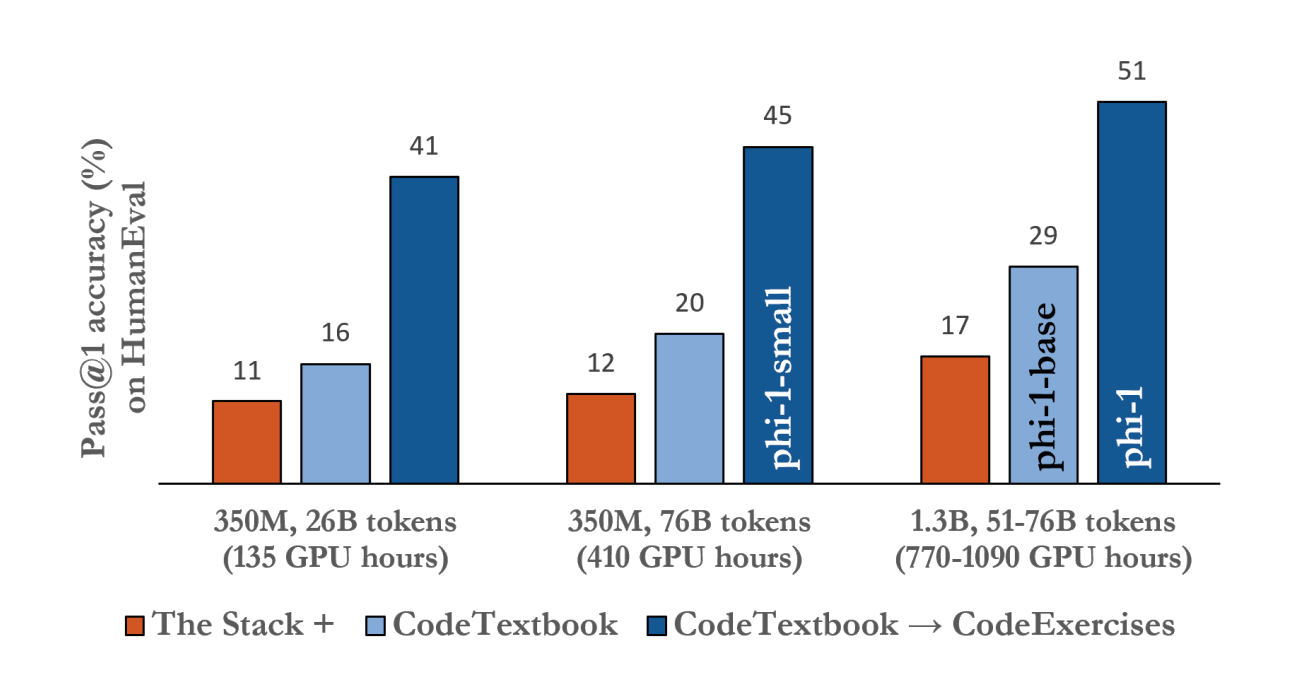
출처: Textbooks Are All You Need (Gunasekar et al., 2023)
언어 모델에서 훈련 데이터의 중요성은 아무리 강조해도 지나치지 않습니다. 위의 연구 사례는 데이터의 중요성을 여실히 보여줍니다. Microsoft 연구진은 소규모 언어 모델(SLM)이 매우 전문적이고 엄선된 데이터 세트로 훈련될 때, 40배 더 큰 모델과도 성능면에서 밀리지 않는다는 것을 보여줬습니다.
데이터를 통해 기대할 수 있는 효과는 무궁무진합니다. 앞선 뉴스레터 #8 지식인이 위키피디아를 만나면 똑똑해질까? 에서도 살펴보았듯이 '훈련시키는 데이터의 조합'에 따라 모델의 성능은 큰 차이를 보이기도 합니다. 다만 문제점은 인간이 생성한 '고품질' 데이터가 부족하다는 것입니다. |
|
|
“2030년부터 2050년까지는 저품질 언어 데이터, 2026년 이전에는 고품질 언어 데이터, 2030년부터 2060년까지는 비전 데이터를 모두 소진할 것입니다.” |
|
|
현재의 데이터 소비와 생산 속도가 유지된다고 가정할 때 EpochAI의 연구는 위과 같이 예측합니다. 이런 데이터 고갈의 한계점을 극복하기 위해서는 AI가 생성한 데이터로 모델을 훈련시키는 방법, 가지고 있는 데이터에 대해 더 많은 훈련을 하는 방법 등이 제시되었지만 아직까지 검증단계에 있다고 합니다. |
|
|
이렇게 AI 연구에 관한 3가지 트렌드에 대해 알아보았습니다. 하지만 아직 163쪽의 방대한 양 중에 아주 일부만 전해드렸는데요! 보고서에는 연구뿐만 아니라 AI 관련 산업, 법률 등 다양한 관점의 현황을 설명하고 있습니다. 다음주에 한 번 더 산업편으로 돌아오겠습니다. 감기 조심하세요!🍂 |
|
|
SNS를 팔로우 하면
최신 소식을 가장 빠르게 확인하실 수 있습니다 😆 |
|
|
deep daiv.
manager@deepdaiv.com
|
|
|
|
|