All in One AI 데이터 솔루션
      2022 Dec week 3 Vol 9      
All in One
AI DATA SOLUTION-
SELECTSTAR
   무엇이든
   물어보살 
   AI에게...
Selectstar→ →

AI SUMMIT Seoul 2022에서 빛난

"DATUMO FST"

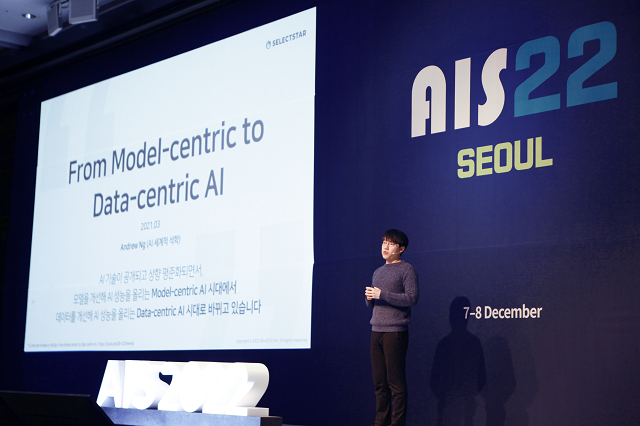
셀렉트스타는 ‘AI 서밋 서울 2022(AI Summit Seoul 2022)’에서 ‘데이터 분석 솔루션 DATUMO FST(Feature Space Tool)’를 공개했습니다. 피쳐스페이스(Feature Space)는 특징 벡터(Feature Vector)가 존재하는 공간으로서 데이터의 정보를 다차원의 점으로 압축한 것입니다.
사용자는 DATUMO FST로 데이터셋의 분포를 눈으로 확인하고 데이터셋의 커버리지(Coverage)와 AI 모델 개선에 필요한 데이터를 보다 구체적으로 파악할 수 있는 엣지 케이스(Edge case)를 분석할 수 있습니다.
또한 선별 알고리즘을 통해 엣지 케이스와 유사한 데이터를 조회하거나 전체 데이터셋을 대표하는 일부 데이터셋을 추출할 수도 있게 되어 기존 기업의 AI 모델 성능 향상에 따르는 비용 및 시간이 대폭 줄어들 것으로 기대하고 있습니다.

셀렉트스타의 김세엽대표는 이날 발표에서 “데이터셋 분석 소프트웨어 서비스(SaaS)를 제공하는 해외 기업 사례가 있지만 국내에서는 ‘AI 서밋 서울’에서 셀렉트스타가 한국 최초로 공개한다”며, “특히 피쳐스페이스 기반으로 자유도 높은 분석과 큐레이션(Curatio)을 통해 엣지 케이스를 해결하는 기술은 글로벌 탑 경쟁사와 비교해도 결코 밀리지 않는다”고 강조했습니다.

셀렉트스타의 DATUMO FST는
현재국내 대기업 및 다수의 스타트업들과 알파테스트를 진행중에 있는데 이번 발표를 기해  알파테스트 참여 기업을 확대 모집 중에 있습니다.
알파테스트에 관심이 있거나 참여를 원하는 단체나, 기관, 기업은 아래 링크로 부담없이 신청하셔서 AI DATA 분야에서 한걸음 앞서가는 얼리어답터가 되십시오.


AI Topic  → →

영재 교육받은 ChatGPT


물어보는 모든 것을 대답해주는 AI가 세상에 공개됐습니다. 그동안 많은 QA(Question&Answering) 인공지능이 있었지만 성능이 썩 좋지 못하거나, 윤리적인 문제에 휘말리곤 했습니다. 그런데 이번에 공개된 ChatGPT는 다릅니다. 데모를 직접 활용해본 사용자들은 말 그대로 ‘깜짝 놀랐다’고 표현을 했는데요. 도대체 무엇이길래 이렇게까지 주목하고 있는지, 이번 아티클에서는 ChatGPT를 소개합니다.

OpenAI는 지난 11월 30일, GPT 3.5을 기반으로 학습한 QA모델 ChatGPT를 선보였습니다. GPT 3.5는 간단하게 요약하면 GPT를 거듭 발전시켜 만든 모델로, 트랜스포머(Transformer)의 디코더(Decoder) 블럭을 활용해 문장 생성에 특화된 모델입닌다.

ChatGPT는 Transformer를 기반으로 하는 GPT의 특성상 입력값에 따른 적절한 출력값을 잘 해냅니다. 그래서 학습을 거듭하면 주어진 질문을 이해하고 그에 대한 적절한 대답을 생성할 수 있습니다.

하지만 이전까지의 GPT 모델은 학습시킨 데이터에 따라 다른 결과물이 출력되기에 성능이 떨어지거나 부적절한 답변을 생성하기도 했습니다. 학습 데이터에 항상 건전하고 올바른 내용만 있는 것은 아니기 때문입니다.

그래서 OpenAI는 새로운 방법을 도입합니다. 바로 RLHF(Reinforcement Learning from Human Feedback)입니다. 직역하면 인간 피드백 강화학습인데요, 지도학습으로 미세조정(파인튜닝)한 초기 모델에 인간이 개입하여 직접 피드백을 제공하는 방법입니다.

다소 강화학습 개념이 생소할 수 있겠습니다. 뜻밖에도 강화(Reinforcement)라는 개념은 심리학에서 기원합니다. 심리학에서 말하는 강화란, 보상(또는 처벌)을 제공함으로써 특정 행동을 하도록 (또는 하지 않도록) 하는 것입니다. 예를 들어, 청소를 한 학생에게 숙제 면제권을 준다면 너도 나도 교실 청소를 하려고 하겠지요. 숙제 면제권이라는 보상을 활용하여 청소라는 특정 행동을 강화시킨 셈입니다.

이처럼 강화학습에서는 행동(Act)에 따른 보상(Reward)을 주어 원하는 결과를 얻도록 합니다. 이때 주어진 환경에서 어떻게 행동할지 결정할 정책(Policy)이 필요하기도 합니다. 전통적인 강화학습은 딥러닝과 별개의 영역이었는데요, 보상을 극대화하기 위한 예측 과정에 딥러닝이 활용되기 시작했습니다.

이제 강화학습이 적용된 ChatGPT의 원리를 하나씩 알아보겠습니다.


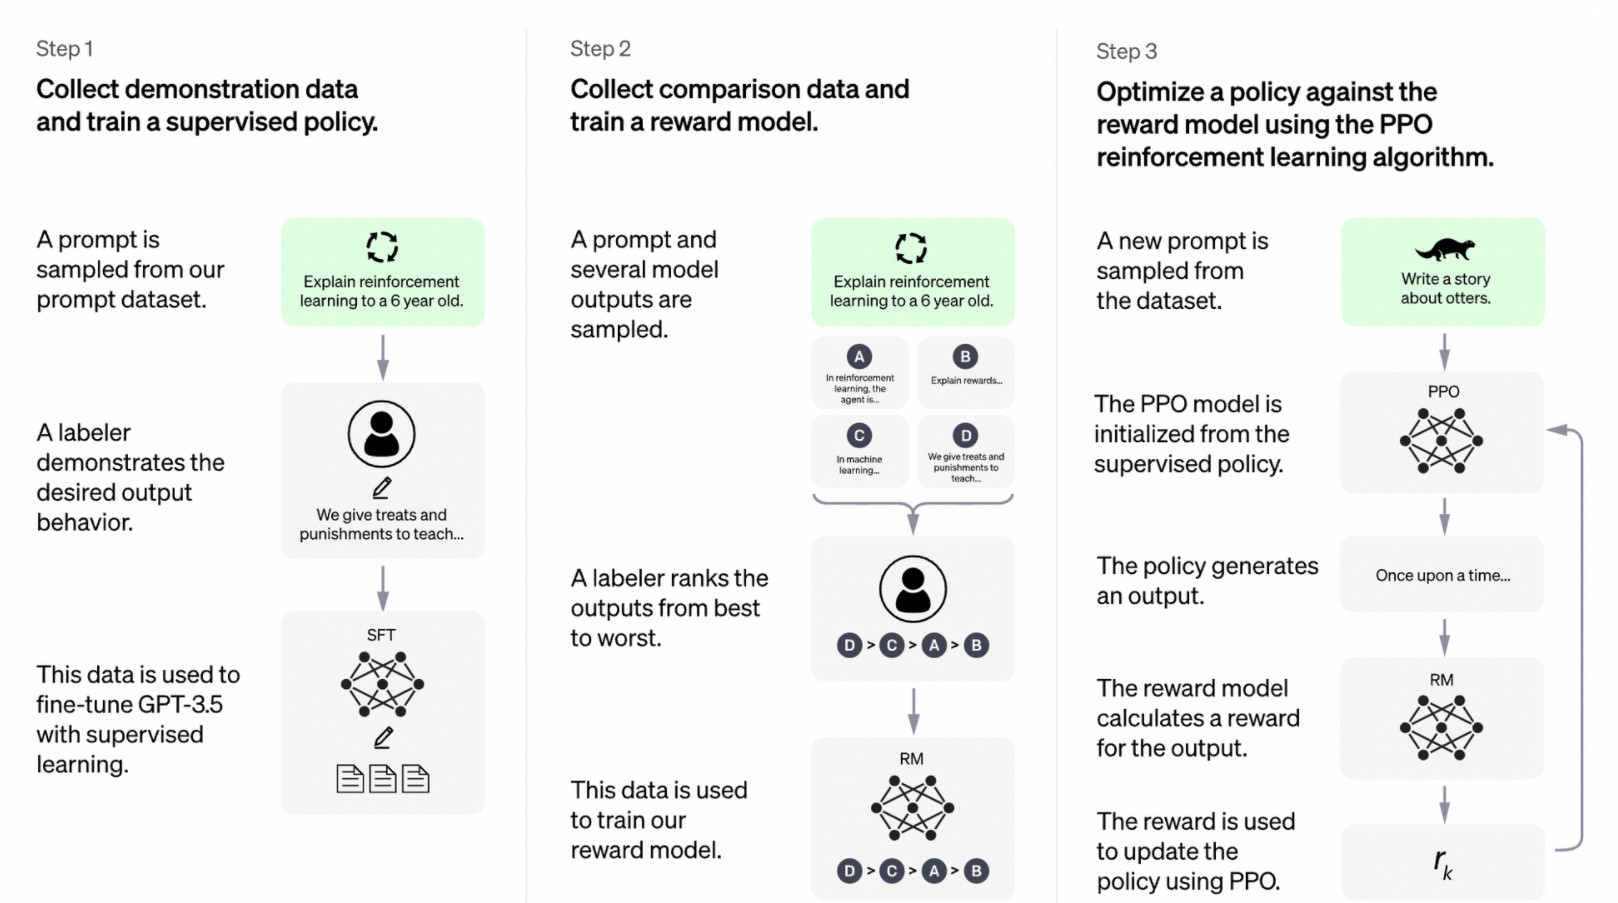
출처: <ChatGPT: Optimizing Language Models for Dialogue>, OpenAI 홈페이지

Step 1. 지도학습 정책으로 훈련

데이터셋에서 입력 프롬프트로 활용될 질문을 추출한 뒤에 인간 라벨러에게 답을 작성하도록 합니다. 라벨러가 작성한 데이터를 정답으로 간주하고 GPT3.5를 파인튜닝합니다. 이 작업은 ChatGPT가 적절한 답변을 생성해 내도록 합니다.


Step 2. 보상 모델 훈련

입력 프롬프트(질문)과 모델이 산출한 결과물(답변)을 여러 개 샘플링합니다. 그리고 다시 인간 라벨러가 직접 답변의 적절성에 따라 순위를 매깁니다. 이 순서는 보상 모델(Reward Model)을 훈련하는 데 활용됩니다. 이를 통해 ChatGPT는 어떻게 답변해야 더 큰 보상을 받을 수 있는지, 다시 말해 어떤 답변이 최고의 답변인지 학습하게 됩니다.


Step 3. PPO 모델을 활용한 정책 최적화

강화학습의 목적은 보상을 극대화하는 것입니다. 보상을 극대화하기 위해서는 좋은 정책을 찾아야 합니다. 새로운 입력 프롬프트에 적절한 답변을 생성하고, 앞서 학습한 보상 모델을 기반으로 새로 생성한 답변에 대한 보상을 계산합니다. 이후 PPO를 통해 산출한 값에 대한 정책 최적화를 진행합니다. PPO는 Proximal Policy Optimization의 약자로, 이 또한 OpenAI가 제시한 강화학습 정책 최적화 방법론입니다. 만약 궁금하신 분들이 있다면 아래 링크를 참고해 보세요.

ChatGPT가 인간스러운 답변을 내놓을 수 있었던 데에는 인간의 데이터 라벨 작업 덕분입니다. ChatGPT는 사람의 작업이 잘 반영될 수 있도록 적절한 강화학습 정책을 활용했습니다. 기존 QA 모델에 주로 활용되지 않았던 학습 방법을 적용한 혁신과 막대한 인적 자본 투자의 결합으로 탄생한 역작이 바로 ChatGPT인 것입니다.

하지만

ChatGPT에도 여러 가지 한계는 있습니다. 몇 가지를 꼽자면 먼저 부적절한 정보마저 그럴 듯하게 설명한다는 점, 그 특성상 완벽한 정답을 내놓지는 못한다는 점, 결국 인간이 제공한 만큼밖에 알 수 없다는 점 등이 있습니다. 주어진 정답을 맞히는 것이 아닌 보상을 극대화하는 방향으로 학습하기 때문입니다. 아직 주어진 데이터에서 스스로 지식을 확장하여 답변하기는 어렵습니다.

또한 동일한 질문을 여러 번 시도할 때 매우 민감하게 반응합니다. 질문의 의미는 같지만 표현이 약간만 달라져도 완전히 다른 답변이 나올 수 있다는 뜻입니다. 마지막으로는 윤리적인 문제입니다. 이것은 어떤 챗봇이라도 겪을 수 있는 문제인데요, 부적절한 질문을 원천적으로 차단하기 위해 API를 활용하는 등의 노력이 있지만 여전히 한계가 있을 수밖에 없습니다.

GPT-4에 대한 전망을 소개한 지 얼마 지나지 않아 ChatGPT가 공개되었는데요. 이렇게 개발된 ChatGPT는 다양한 분야에 접목되어 응용될 것으로 보입니다. 공부하다 모르는 게 생기면 멘토처럼 답변을 해줄 수도 있고, 심심할 때는 친구처럼 대화할 수도 있을 것입니다. 앞으로 GPT가 바꾸어 나갈 세상이 점점 더 기대가 되시나요? 아니면 무서워지나요?

AI LEADERS FORUM  → →
AI, 머신러닝(ML), 뇌과학 분야에서 최상급 권위의 인공지능(AI) 학회 '뉴립스(NeurlIPS, 인공신경망학회)'. 이곳에 한국 최초의 조직위원으로 선정된 연구자를 무려 세분이나 모시고 들어본 AI의 미래 비전.
신청자만 500명이 넘었고 실시간 접속자만 400명이 넘었던 뜨거웠던 호응.

* 다음주에 특집기사로 보여드립니다!
  Coming Soon... 
  AI NETWORKING NIGHT → → 
12월의 AI NODAJI는 AI LEADERS FORUM 관계로 채굴을 쉬었습니다.
2023년 1월 업그레이드 되는 AI NODAJI를 기대해주세요! 
Weekly AI Issues  → →

AI 호텔리어

고객 음성인식 통해 서비스 제공...키오스크 대비 편의성 강화

KT와 딥브레인이 공동 개발한 컨시어지 서비스가 실제 호텔에 도입되었습니다. KT는 기존 키오스크보다 편의성이 높다고 누구나 쉽게 사용할 수 있는 것이 장점이라고 밝혔습니다.


정부, AI 반도체 산업에 투자한다

정부, AI반도체에 ‘30년까지 총 8262억 투입한다

정부가 AI 국가 경쟁력 제고를 위해 AI 반도체 개발에 대규모 투자를 진행한다고 밝혔습니다. 좋은 AI 모델도 필요하지만 모델이 운용될 수 있는 AI 반도체 또한 매우 중요합니다.


삼성전자-네이버, AI 반도체 개발을 위해 손잡다

데이터 병목 해결하고 전력 효율 극대화…'초대규모 AI'에 최적화

국내 AI를 선도하는 두 기업이 손을 잡았습니다. 삼성전자와 네이버는 AI 반도체 솔루션 개발을 위해 협력하기로 밝혔습니다.


ChatGPT가 수능을 본다면

당신은 이 AI보다 수능 점수가 높습니까? 

ChatGPT가 수능을 푼다면 어떨까요? 결과는 최대 71%를 정답률이라고 합니다. 이는 수능 3-4등급에 해당하는 수치입니다.


Selectstar Culture → →

가짜뉴스로 밝혀진 저 기사가 한 개도 부럽지 않은
셀렉트스타의 핵심가치이자 최고 장점은 바로, "자율"

1-5시 코어타임만 지키면 그 외엔 언제 어디서나
나에게 맞는 편한 환경에서 업무가 가능합니다.
자율이 보장된다는 건 내가 가장 일을 잘할 수 있는 환경에서 일하고,
휴식할 땐 온전히 충전할 수 있다는 거에요.

Join Us  → →

지금 AI 데이터 업계에서
제일 밝게 빛나고 있는
셀렉트스타와 함께 하세요!

현재 채용중인 포지션
 🎮 백엔드 개발자 지원하기: bit.ly/selectstar-backend
Promotion  → →

타업체 견적 대비 10%(최대 500만원)의 할인 혜택을 드립니다

*셀렉트스타는
실무에 바로 활용할 수 있는
오픈 데이터셋 자료를
 무료로 제공해드립니다
홈페이지에서 신청해보세요
셀렉트스타 주식회사
📨  비즈니스 문의 및 제휴 contact@selectstar.ai
서울특별시 강남구 역삼동 테헤란로 20길 20 8층, 10층, 11층
1666-3282 (1666-DATA)

*본 콘텐츠는 deep daiv. 와의 제휴로 구성 되었습니다.