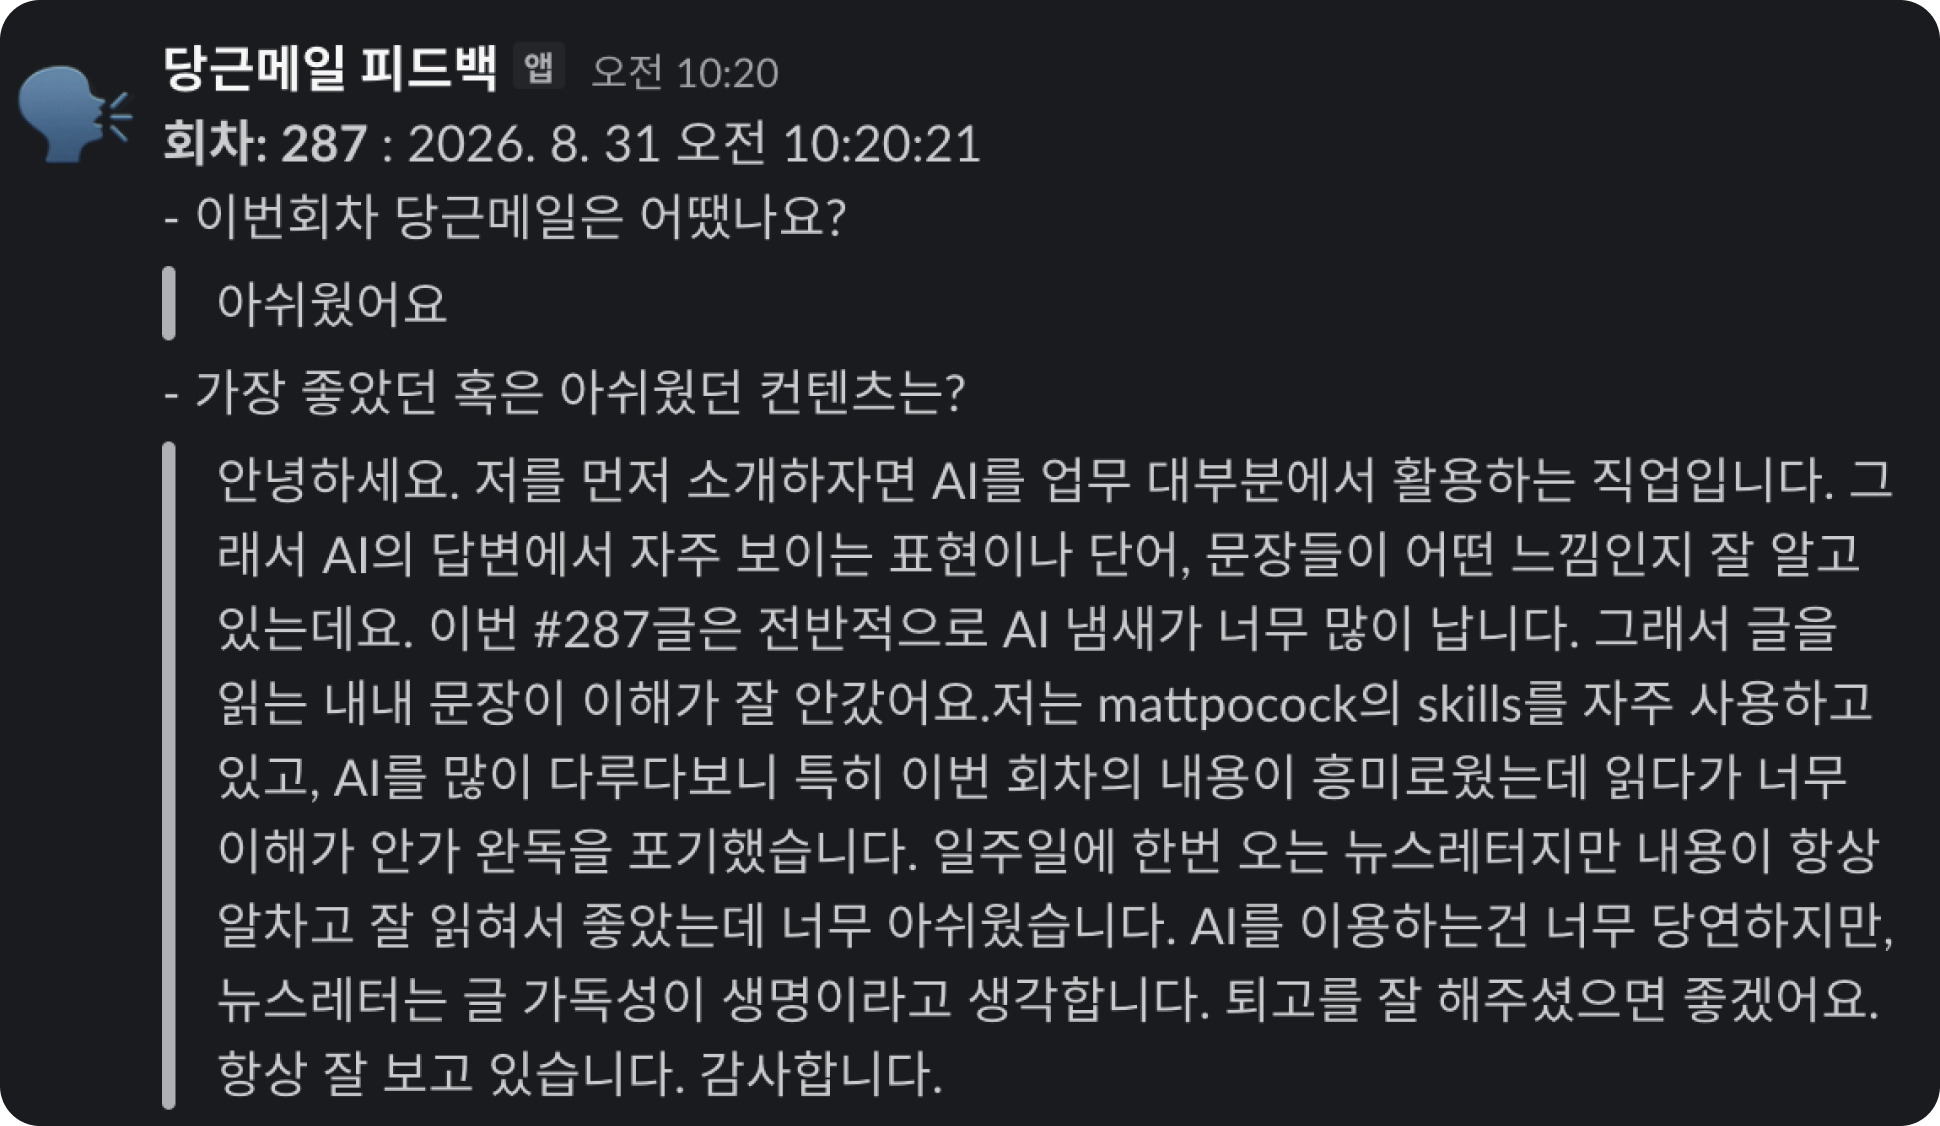
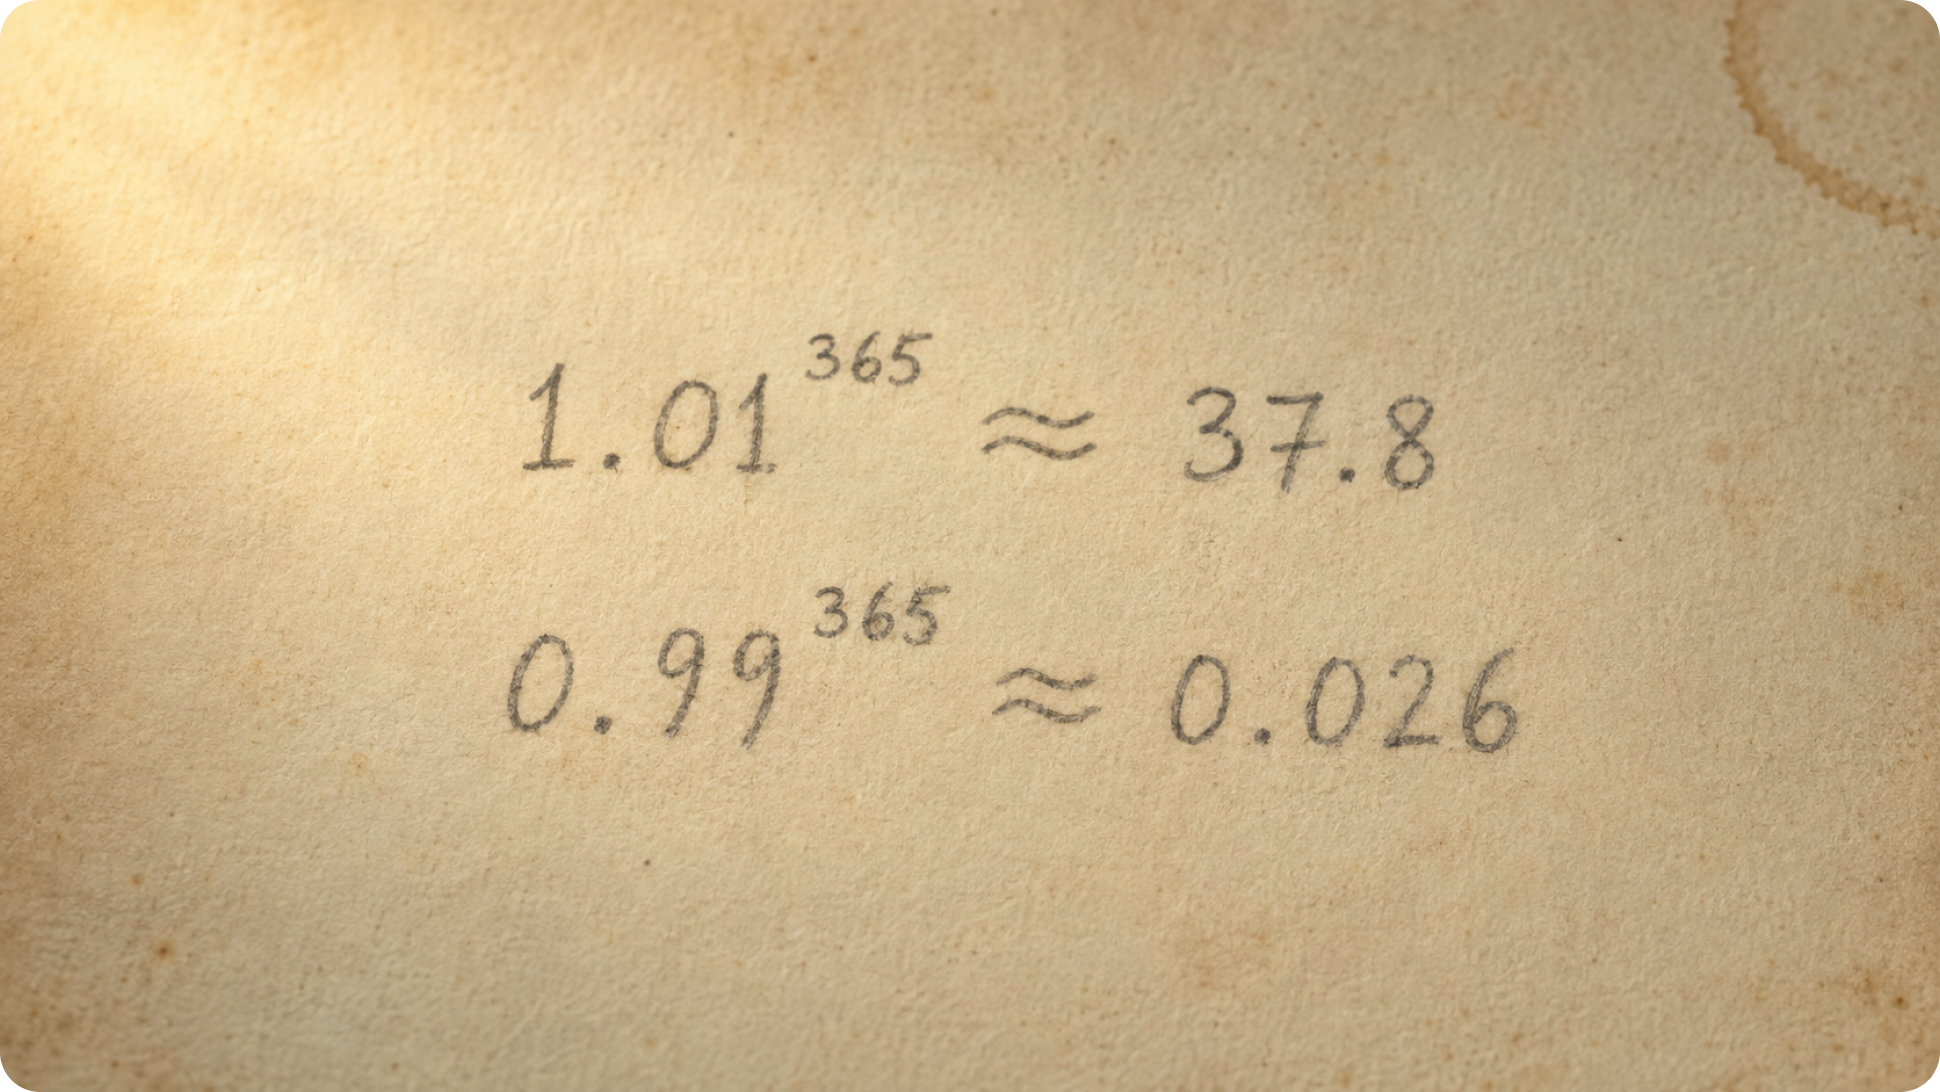"이번 #287글은 전반적으로 AI 냄새가 너무 많이 납니다. 그래서 글을 읽는 내내 문장이 이해가 잘 안갔어요. ... 읽다가 너무 이해가 안가 완독을 포기했습니다."
사실 지난 회차는 마감을 맞추느라 그 어느 때보다 AI에게 더 의지를 많이 했습니다. 그럼에도 나름 읽어보고 다시 AI에게 고쳐달라고를 반복했죠. 그럼에도 그 결과는 읽기 힘든 AI 슬롭이 된 것이죠.
역시나 원고를 열 번 넘게 주고받는 동안 제 손으로 고친 판본이 하나도 없었던 것이 문제였습니다. 대조할 원본 자체가 남아 있지 않았습니다. 매번 최신본만 읽었고, 최신본 하나만 놓고 보면 언제나 괜찮아 보입니다.
앞에서 말한 그 실험이 확인한 것이 하나 더 있습니다. 자동화가 틀리는 장면을 훈련 중에 한 번이라도 직접 겪게 하면, 확인하는 행동이 돌아온다는 것입니다.
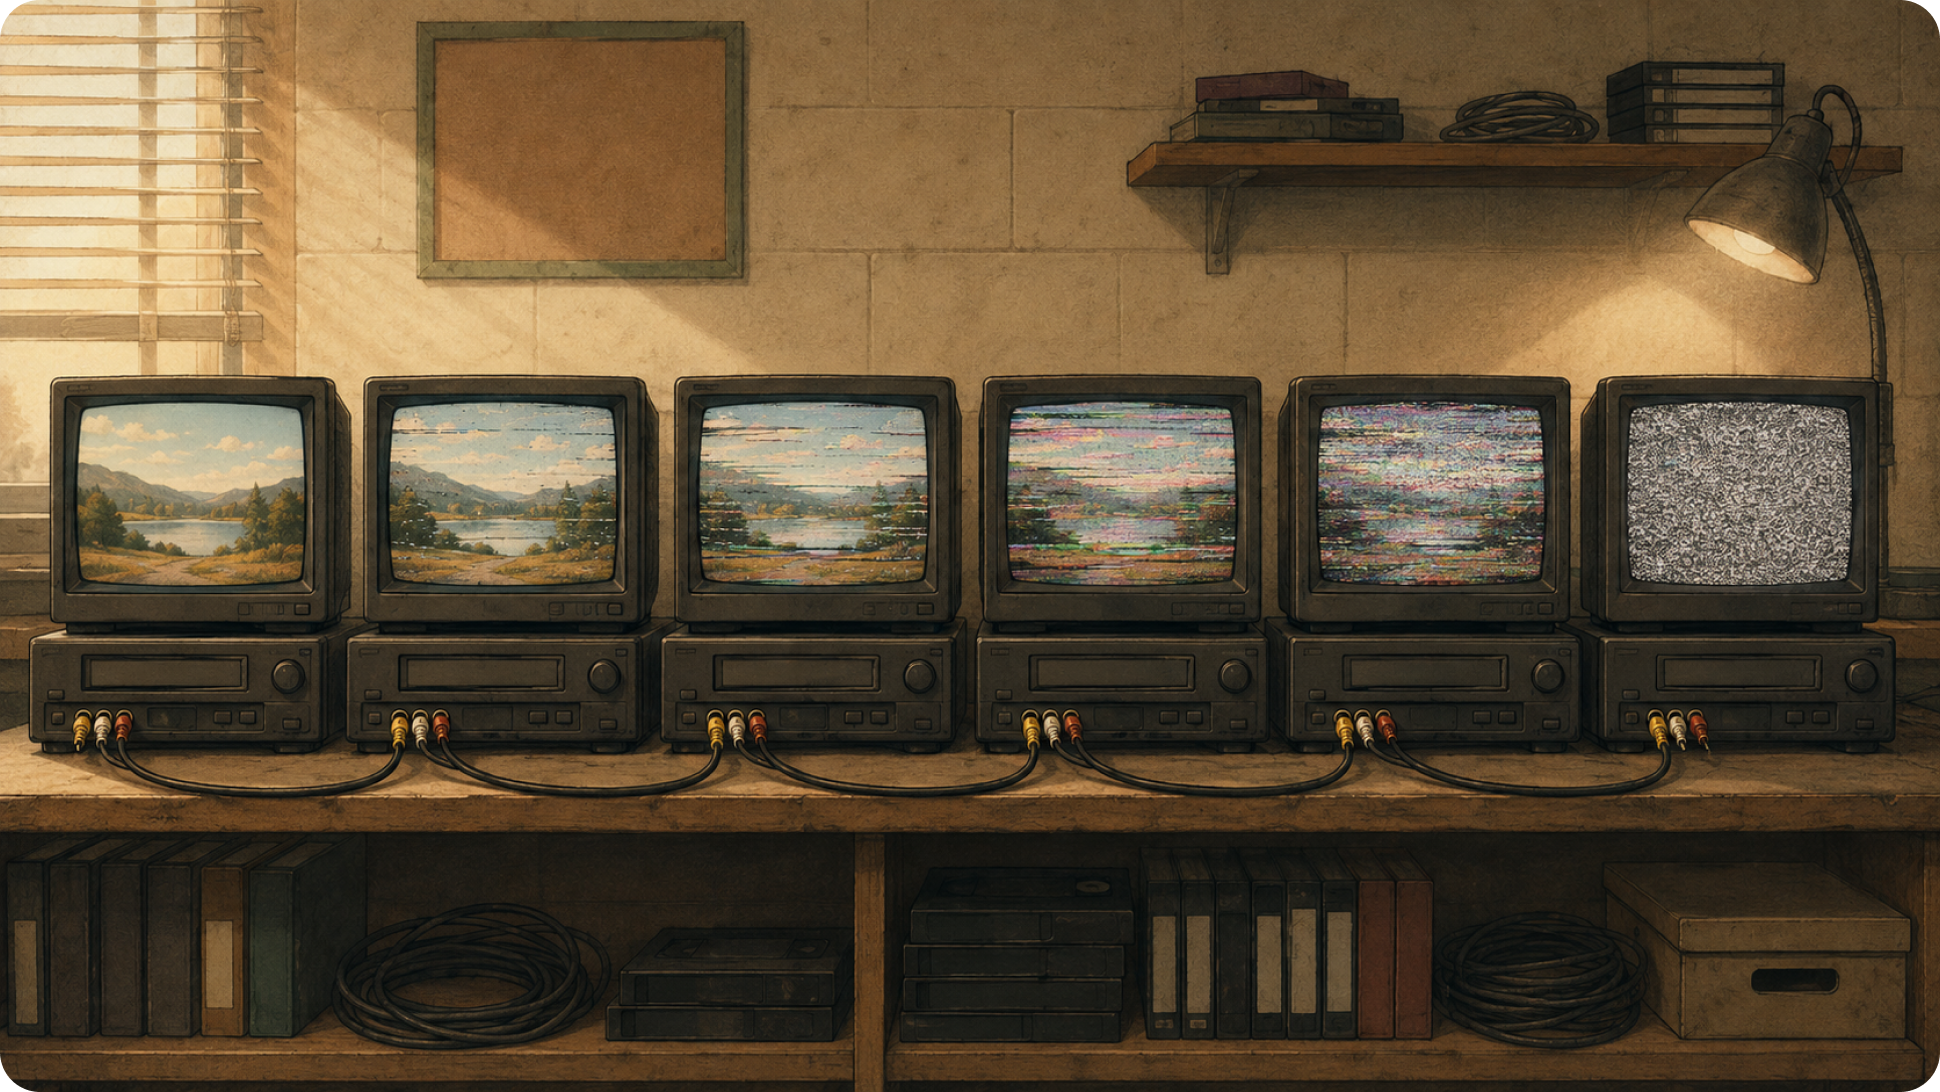
저에게는 이 피드백이 그 장면이었습니다. 지지직거리는 3번 테이프를 대신 봐주신 셈이죠. 이 자리를 빌려 고맙다는 말씀을 드리고 싶습니다. 그리고 제 글의 마지막은 반드시 제 손으로 다듬어야겠다고 생각하고 글을 쓰고 있어요.
나빠진 것을 우리가 못 느낀다는 게 진짜 문제입니다
"그래도 나빠지면 알아차리지 않을까요?"
저도 그렇게 생각했습니다. 그래서 이를 직접 측정한 실험이 있습니다.
METR이라는 연구 기관이 2025년에 경력 개발자 16명을 데리고 무작위 대조시험을 했습니다. 남의 코드가 아니라 자기 저장소에서, 평균 5년 이상 다뤄온 코드베이스로, 실제 과제 246개를 처리하게 했습니다. 과제마다 AI 도구를 쓸지 말지를 무작위로 배정했고요.
시작 전 예상 → 24% 빨라진다
끝난 뒤 체감 → 20% 빨라졌다
실제 측정 → 19% 느려졌다
핵심은 "AI가 더 느렸다"가 아닙니다. 그건 이 실험 하나로 일반화할 수는 없습니다.
오히려 중요한 점은 일이 끝난 뒤에도 자기가 느려진 것을 몰랐다는 것입니다. 실제로는 19% 느려졌는데 20% 빨라졌다고 느꼈습니다. 체감과 현실 사이에 39%포인트가 벌어져 있었고, 그 간격을 본인은 인식하지 못했습니다.
스탠퍼드에서 나온 비슷한 결과도 있습니다. AI 어시스턴트를 쓴 참가자들이 과제 5개 중 4개에서 더 취약한 코드를 썼는데, 그러면서 자기 코드가 더 안전하다고 믿었습니다. 연구자들은 이걸 거짓 안정감이라고 불렀습니다.
품질이 떨어지는 것과 떨어진 걸 모르는 것은 다른 문제입니다. 앞의 것은 고칠 수 있고, 뒤의 것은 고칠 기회조차 오지 않습니다.
AI에게 다시 고치라고 해도 나아지지 않습니다
여기까지 오면 자연스럽게 드는 생각이 있습니다. "그럼 AI한테 검토도 시키면 되지 않나?"
저 역시 실제로 그렇게 해왔고, 그게 잘 안 되는 것을 경험했습니다. 그리고 이건 제 감이 아니라 실험으로 확인된 것이기도 했습니다.
구글 딥마인드가 2024년에 발표한 연구는 외부 피드백 없이 모델이 자기 답을 스스로 고치는 방식을 검증했습니다. 결론은 이렇습니다. 추론 과제에서 LLM은 외부 피드백 없이 자기를 고치지 못하며, 자기교정을 거친 뒤 성능이 오히려 떨어지는 경우도 있었습니다.
이유는 어렵지 않습니다. 자기 답을 만든 쪽은 그 답의 전제를 이미 받아들이고 있기 때문입니다. 사람도 마찬가지죠. 자기가 쓴 보고서에서 오타는 찾아도 자기 논리가 틀렸다는 건 잘 못 찾습니다. 익숙한 가정은 눈에 안 보입니다.
그러니 AI가 고친 것을 AI에게 다시 검토시키는 건 복사 체인을 한 세대 더 늘리는 일입니다. 검증이 아니라 복사입니다.
그리고 이건 제 문서에서만 벌어지는 일이 아닙니다
2024년 7월 『네이처』에 실린 연구가 하나 있습니다. 제목이 「재귀적으로 생성된 데이터로 학습하면 AI 모델은 붕괴한다」입니다. 슈마일로프 연구팀이 낸 논문인데, 실험이 제가 방송반에서 했던 짓과 동일합니다.
언어 모델 하나를 학습시킵니다. 그 모델이 만들어낸 글을 모아서 다음 세대 모델의 학습 데이터로 씁니다. 그 모델이 만든 글을 다시 그다음 세대에 먹입니다. 데크를 줄줄이 이어 놓은 것과 같은 구조죠.
9세대쯤 되었을 때, 연구진이 영국 서머싯 지방 교회 첨탑의 건축 양식에 대해 물었습니다. 모델은 꼬리가 긴 산토끼 이야기를 색깔만 바꿔가며 반복했습니다. 첨탑과는 아무 상관이 없는 답이었죠. 열 세대를 넘기지 못하고 무너진 겁니다.
그런데 제가 이 논문에서 진짜로 배운 건 붕괴가 아니라 무엇이 먼저 사라지는가였습니다.
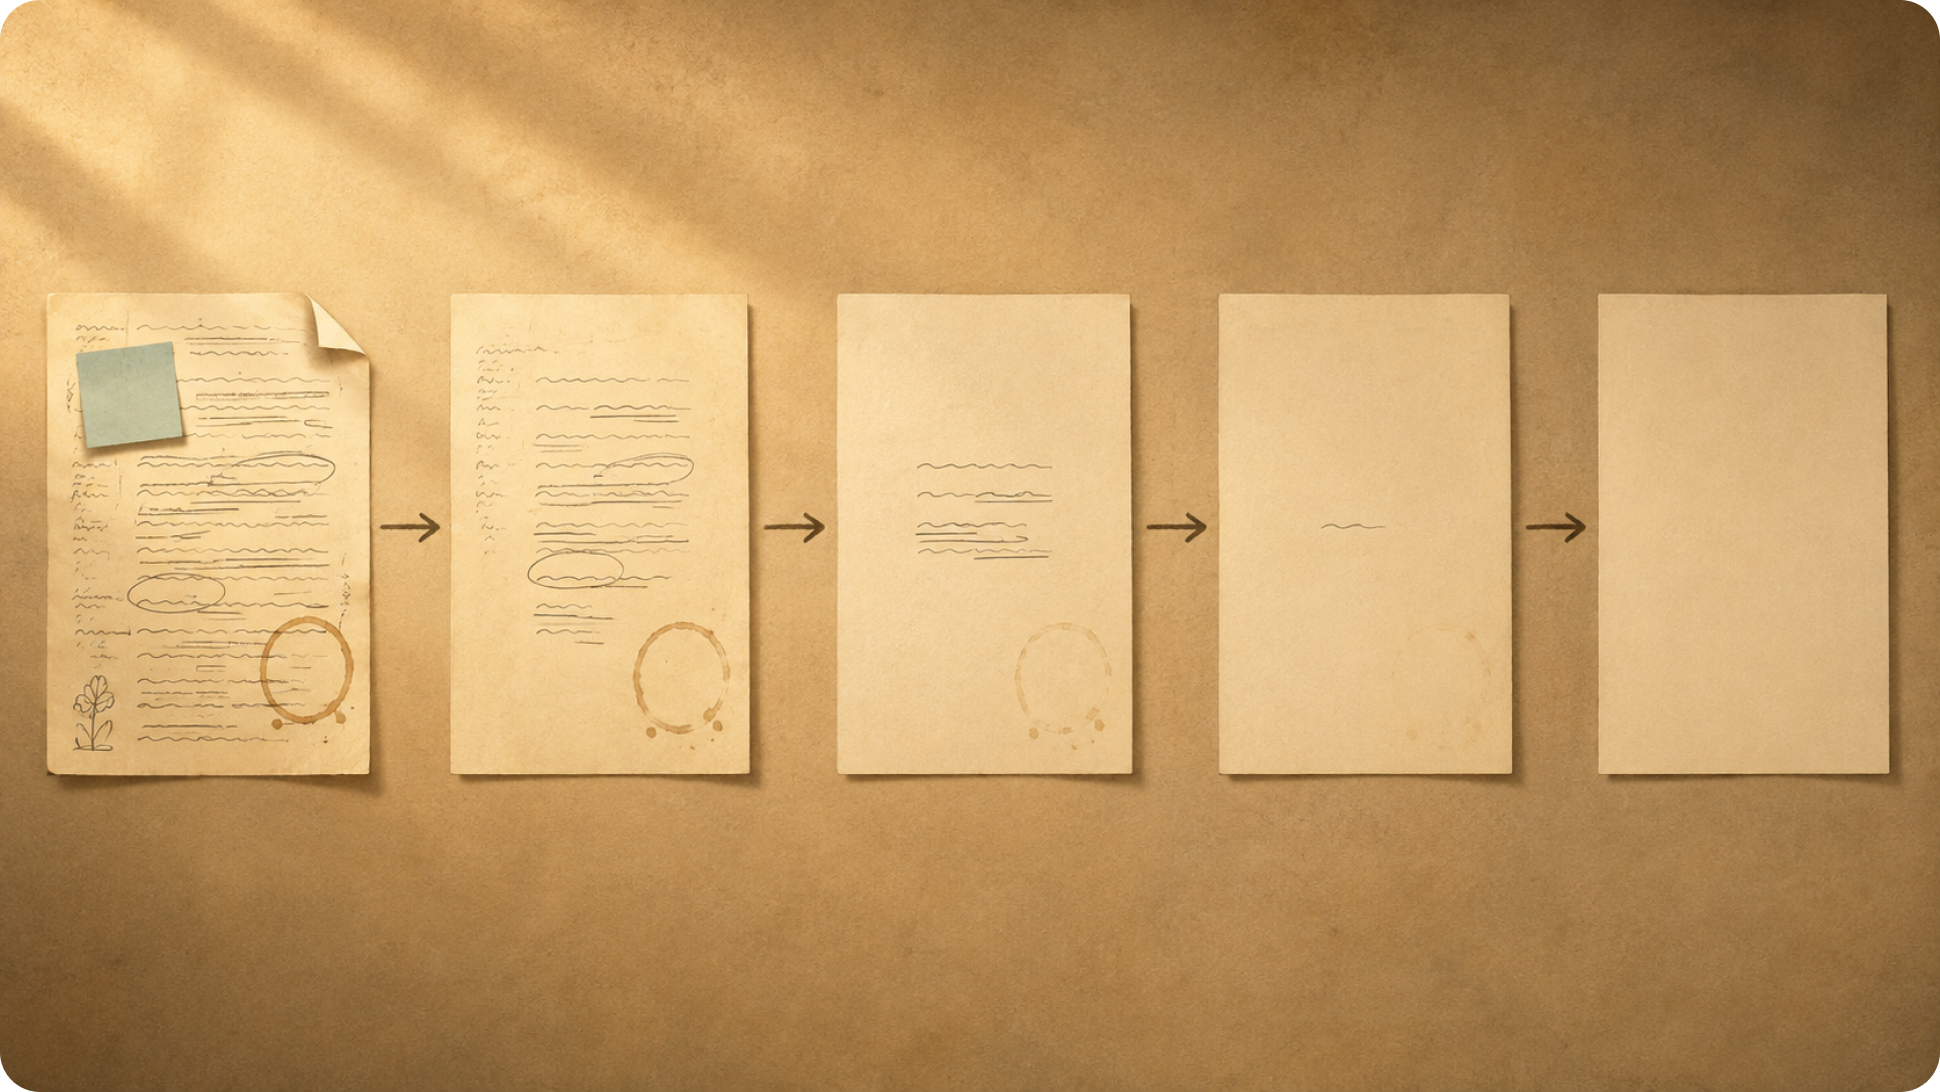
논문은 분포의 꼬리가 먼저 사라진다고 말합니다. 자주 나오는 흔한 것은 오래 살아남고, 드물게 나타나는 것부터 없어진다는 뜻입니다. 그리고 이 손상은 되돌릴 수 없다고 못 박습니다.
제 원고에서도 정확히 그랬습니다. 회차가 돌수록 먼저 사라진 것은 구체적인 숫자, 제가 겪은 일화, 제가 즐겨 쓰는 조금 이상한 표현이었습니다. 다시 말해 가장 저다운 문장부터 사라졌습니다. 흔하고 무난한 문장은 끝까지 남고요.
AI가 다듬은 글이 매끄러운데 심심한 이유가 여기 있습니다. 나빠진 게 아니라 평균에 가까워진 것이고, 평균은 원래 매끄럽습니다.
그래서 저는 복사 체인을 끊어야 합니다
정리하면 다음과 같습니다.
1. 오차가 작아서 안 보이고
2. 안 보이니까 안 고치고
3. 안 고친 채로 다음 입력이 됩니다.
그래서 처방도 이 셋을 각각 겨냥해야 합니다. 노이즈가 저절로 보이지 않으면, 우리가 보이게 만들어야 하죠.
1. 이어서 고치지 말고, 원본에서 다시 시작합니다
가장 효과가 컸던 건 이것 하나였습니다.
대화를 길게 끌면서 "여기 고쳐줘"를 스무 번 하면 스무 세대가 쌓입니다. 대신 저는 서너 번 주고받은 뒤 창을 닫습니다. 그리고 원본 문서를 직접 고쳐서 새 대화에 다시 붙여 넣고 처음부터 시작합니다.
데크로 치면 1번에서 2번, 2번에서 3번으로 잇는 대신 매번 1번 데크에서 복사하는 것입니다. 열 개를 뜨는 시간은 더 걸립니다. 대신 열 개가 다 볼 만합니다.
2. 세 번에 한 번은 제 손으로 고칩니다
지적하지 말고 직접 고칩니다. 문장 두세 개라도 좋습니다.
제가 손으로 고친 판본이 다음 회차의 입력이 되어야 원본이 갱신됩니다. 지시만 하면 제 판단은 원고에 남지 않고 AI의 해석을 한 번 거쳐서 들어옵니다. 그 해석이 바로 1%죠.
실제로 제 당근메일 작업 지침 중에 제일 쓸모 있는 대목은, AI가 쓴 초안과 제가 직접 고친 판본을 나란히 놓고 대조해서 뽑아낸 것들입니다. 제 손이 닿은 판본이 있어야 대조할 원본이 생깁니다.
3. 원본과 나란히 놓고 무엇이 바뀌었는지 봅니다
VHS는 친절했습니다. 나빠지면 알아서 지지직거렸으니까요. AI는 안 알려주니 우리가 만들어야 합니다.
그래서 3회차쯤에서 한 번은 첫 초안과 지금 원고를 나란히 열어 놓고 무엇이 사라졌는지 확인합니다. 방금 받은 원고만 읽으면 절대 안 보입니다. 그 원고 하나만 놓고 보면 언제나 괜찮아 보이거든요. 나빠졌다는 건 오직 비교했을 때만 보입니다.
4. 고친 쪽 말고 다른 쪽에 검증을 맡깁니다
같은 대화 안에서 "이거 검토해줘"는 검증이 아닙니다. 새 대화를 열거나, 다른 모델에 넘기거나, 사람에게 보여줍니다.
그리고 물어보는 방식도 바꿉니다. "잘 썼어?"라고 물으면 잘 썼다고 합니다. "이 문장의 근거가 원문 어디에 있어?"라고 물어야 합니다. 앞의 질문은 평가를 요구하고, 뒤의 질문은 대조를 요구합니다. 대조는 원본이 있어야만 할 수 있으니 거짓말을 하기 어렵습니다.
여기서 한 가지 미리 말씀드리면, "AI한테 설명을 잘 붙이게 하면 되지 않나"는 효과가 별로 없습니다. 부친자 연구팀이 2021년에 확인한 바로는 설명을 붙이는 것만으로는 과의존이 줄지 않고, 오히려 늘어날 수도 있습니다. 사람이 추천을 하나하나 따져보는 대신 "따를지 말지"라는 습관을 통째로 만들어버리기 때문입니다.
효과가 있었던 건 생각하지 않고는 넘어갈 수 없게 만드는 구조였습니다. 위의 3번과 4번이 그런 장치입니다. |