4%p. 미국 국립보건원(NIH)에 들어온 연구비 제안서를 비교하니, AI가 많이 관여한 제안서가 적게 관여한 제안서보다 선정 확률이 약 4%p 높았습니다. 여기까지는 고개가 끄덕여집니다. 문장이 매끄럽고 구성이 잘 정리돼 있으면 심사위원 눈에도 잘 들어오겠죠. 그런데 같은 연구에서 AI 관여도가 높은 제안서는 아이디어의 독창성이 낮았고, 기관이 바로 전년도에 지원한 주제와 더 비슷했습니다. 덜 새로운 제안서가 더 잘 뽑혔다는 이야기입니다.
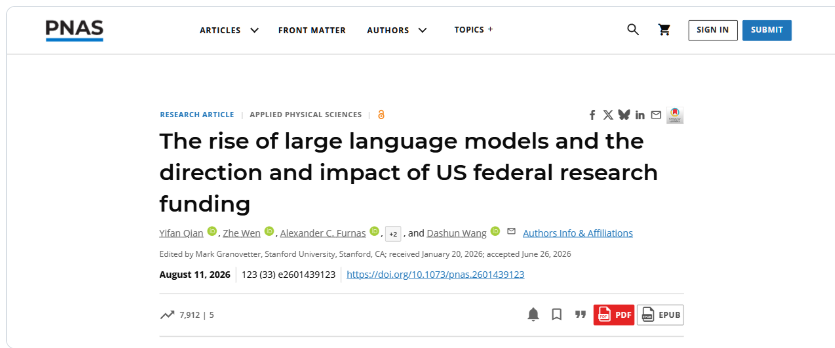
노스웨스턴대 다슈안 왕(Dashun Wang) 교수 연구진이 PNAS에 발표한 The rise of large language models and the direction and impact of US federal research funding의 내용이고, 국내에는 PsyPost의 소개 기사로 먼저 알려졌습니다. 이번 호에서는 이 숫자를 천천히 읽어 보겠습니다. 기획서·품의서·사업계획서를 받아 결재하고 예산을 나누는 임원·경영진, 그리고 사내 심사위원을 맡는 리더를 생각하며 썼습니다. 이미 많은 직원이 생성형 AI로 문서 초안을 쓰고 있으니, 이제 들여다볼 곳은 쓰는 쪽보다 고르는 쪽입니다.
무엇을, 어떻게 쟀나
연구진은 데이터를 두 갈래로 모았습니다. 하나는 미국 대형 연구중심대학 두 곳의 내부 자료입니다. 선정된 제안서뿐 아니라 탈락했거나 심사 중인 제안서까지 들어 있고, 국립과학재단(NSF) 제안서 약 1,600건과 NIH 제안서 약 4,100건입니다. 다른 하나는 공개 데이터베이스인 Dimensions에 올라온 전국 단위 선정 과제로, NSF 약 5만 7,000건과 NIH 약 7만 4,000건입니다. 과제 시작 시점은 2021년부터 2025년까지입니다. 주제 개요에서 말한 '13만여 건'은 이 선정 과제 데이터를 가리킵니다.
AI 관여도를 잰 방법도 알아 둘 필요가 있습니다. 연구진은 ChatGPT가 나오기 전인 2021년의 제안서 초록을 기준으로 삼고, 이 초록을 GPT-3.5로 다시 쓰게 해서 AI 특유의 단어 선택 패턴을 모델링했습니다. 그다음 실제 초록에서 AI가 고친 것으로 보이는 문장의 비율을 추정했습니다. 이 수치는 2022년 말까지 거의 평평하다가 2023년부터 가파르게 올랐습니다. NIH도 NSF와 시기는 같았지만 수준은 더 낮았습니다.
숫자가 말하는 것: 비슷해졌고, 더 잘 뽑혔다
첫 번째 결과는 독창성입니다. AI 관여도가 상위 25% 지점인 제안서는 하위 25% 지점인 제안서보다 독창성 점수가 NSF에서 약 5 백분위, NIH에서 약 4 백분위 낮았습니다. 여기서 독창성이 낮다는 말은 기관이 전년도에 지원한 주제에 더 가깝다는 뜻입니다. 문장 스타일이 비슷해졌다는 이야기가 아니라 연구 주제 자체가 기존에 돈을 받은 쪽으로 몰렸다는 이야기죠.
이 대목에서 '문장을 AI가 다듬었으니 단어가 비슷해 보이는 것 아니냐'는 반론이 나올 수 있습니다. 연구진도 이 점을 확인했습니다. 2021년 사람이 쓴 초록과, 같은 아이디어를 AI로 다시 쓴 초록의 독창성 점수를 비교했더니 거의 같았습니다. 문체를 바꿔도 점수가 움직이지 않으니, 점수 차이는 표현보다 내용, 곧 과제가 어디에 자리 잡고 있는지를 반영한다는 해석입니다.
두 번째 결과가 선정 확률입니다. NIH에서는 AI 관여도가 하위 25%에서 상위 25% 지점으로 갈 때 선정 확률이 약 4%p 높아졌습니다. NSF에서는 통계적으로 유의한 차이가 없었습니다. 세 번째로 성과를 보면, NIH에서는 AI 관여도가 높은 과제의 논문 수가 약 5% 많았지만 피인용 상위 5%나 1%에 드는 논문에서는 유의한 차이가 없었습니다. NSF에서는 논문 수와도 관계가 나타나지 않았습니다.
세 결과를 이어 보면 이렇습니다. AI가 많이 들어간 제안서는 익숙한 주제 쪽에 있었고, 적어도 NIH에서는 그런 제안서가 더 많이 뽑혔으며, 뽑힌 뒤 논문은 조금 더 냈지만 크게 주목받는 성과가 더 나오지는 않았습니다. 무난한 과제가 무난한 결과를 낸 셈입니다.
이 숫자로 말할 수 없는 것
여기서 'AI가 아이디어를 평범하게 만든다'고 단정하면 연구가 말한 것보다 앞서 나가게 됩니다. 연구진이 밝힌 한계는 이렇습니다.
먼저 관찰 연구입니다. AI 사용과 주제 수렴, 선정 확률이 함께 움직인다는 것은 보여 주지만 AI가 원인이라는 것은 보여 주지 못합니다. 원래 주류 주제를 다루던 연구자가 AI를 더 많이 썼을 가능성도 이 자료만으로는 배제할 수 없습니다. 다음으로 AI 관여도는 초록의 어휘로만 추정했습니다. 브레인스토밍이나 자료 분석에 AI를 쓴 경우는 잡히지 않습니다. 내부 자료는 두 대학에서만 나왔고, 논문 성과는 선정 뒤 1~2년만 추적했습니다. 장기적인 영향은 아직 모릅니다.
선정 확률 4%p도 범위를 지켜 읽어야 합니다. NIH에서만 나타났고 NSF에서는 유의하지 않았습니다. 기사는 이 표본의 기본 선정률도 밝히지 않아서 4%p가 상대적으로 얼마나 큰 차이인지는 판단하기 어렵습니다. 그러니 이 연구에서 안전하게 가져갈 결론은 'AI 시대에 심사 제도가 익숙한 아이디어 쪽으로 기울 수 있다는 신호가 대규모 데이터에서 관찰됐다' 정도입니다. 이 정도만으로도 경영진에게는 충분히 따져볼 만한 신호입니다.
고르는 쪽의 기울기는 원래 있었다
이번 연구가 새삼스럽지 않은 이유가 있습니다. 심사하는 사람이 새로운 아이디어에 박하다는 증거는 AI 이전부터 쌓여 있었거든요.
Boudreau, Guinan, Lakhani, Riedl(2016)이 Management Science에 발표한 연구는 한 연구중심대학의 연구비 공모에서 심사위원과 제안서를 무작위로 짝지어 2,130개 평가 쌍을 만들었습니다. 그 결과 독창성이 아주 높은 제안서일수록 낮은 점수를 받았고, 심사위원 자신의 전문 분야에 가까운 제안서도 낮은 점수를 받았습니다. 연구진은 이런 패턴이 단순한 잡음이나 심사위원의 사적 이해관계로는 설명되지 않으며, 제한된 합리성 속에서 새로운 아이디어를 평가할 때 생기는 편향에 가깝다고 봤습니다.
기업 안의 심사도 비슷합니다. Criscuolo, Dahlander, Grohsjean, Salter(2017)가 Academy of Management Journal에 발표한 연구는 한 전문서비스 기업의 R&D 과제 선정을 분석했습니다. 적당히 새로운 과제가 가장 많이 선정됐고, 지나치게 새로운 과제는 오히려 밀렸습니다. 패널의 업무 부담이 클수록 새로움을 덜 선호했고, 패널의 전문성이 다양할수록 새로움을 더 선호했습니다. 새로운 안건은 판단하는 데 품이 더 든다는 설명입니다. 공저자 크리스쿠올로는 임페리얼 칼리지 해설에서 필요하면 외부 사람까지 넣어 패널의 경험을 다양하게 구성하라고 권합니다.
두 연구와 이번 PNAS 연구를 겹쳐 보면 하나의 가설이 나옵니다. 심사자는 원래 익숙하고 판단하기 쉬운 안건 쪽으로 기울어 있었고, 생성형 AI는 바로 그 익숙한 방향의 문서를 매끄럽고 빠르게 만들어 줍니다. 앞의 두 연구는 AI를 다루지 않았으니, 이 연결은 제 해석이고 검증된 인과는 아닙니다. 다만 경영진이 경계할 이유로는 충분합니다. 예전에 생성형 AI는 성과 평가를 바꿀까?에서 AI 평가문이 유창하고 자신감 있는 어조로 수렴해 부실한 근거를 가릴 수 있다고 말씀드렸는데요. 기획서에서도 같은 일이 생길 수 있습니다. 문장의 완성도가 생각의 새로움을 대신 평가받는 것이죠.
우리 조직의 심사표를 다시 본다면
가상의 장면으로 생각해 보겠습니다. 한 회사의 신사업 공모에 기획안 스무 건이 올라왔습니다. 대부분 목차가 깔끔하고 시장 규모 수치와 리스크 대응표까지 갖췄습니다. 그중 두세 건만 문장이 거칠고 근거도 덜 다듬어졌는데, 질문 자체는 낯섭니다. 심사위원 다섯 명이 하루에 스무 건을 본다면 어느 쪽 점수가 높을까요? 앞의 연구들대로라면 답은 어렵지 않습니다. 그리고 그 회사의 내년 포트폴리오는 올해와 꽤 닮아 있을 겁니다.
그렇다고 AI 사용을 막자는 말은 아닙니다. 막아도 효과가 없을뿐더러, 문서를 정리하는 데 드는 시간을 줄여 주는 이점은 분명합니다. 바꿀 곳은 심사하는 방식입니다. 연구 결과에서 끌어낼 수 있는 방향을 몇 가지 제안드립니다. 검증된 처방이 아니라 조직에서 시험해 볼 만한 출발점으로 봐 주세요.
첫째, 점수표에서 문서 완성도와 아이디어의 새로움을 따로 매기게 하십시오. 한 칸에 섞어 두면 매끄러운 문서가 새로움 점수까지 가져갑니다. 둘째, 기획서마다 '작년에 승인된 안건과 무엇이 다른가'를 한 문단으로 쓰게 하십시오. 이번 연구가 독창성을 잰 기준이 바로 전년도 지원 주제와의 거리였습니다. 그 거리를 쓰는 사람이 직접 밝히게 하자는 겁니다. 셋째, 심사 부담을 줄이고 패널을 다양하게 꾸리십시오. Criscuolo 등의 연구에서 바쁜 패널일수록 새로움을 덜 선호했습니다. 한 번에 몰아서 보는 심사보다 나눠서 보는 심사가, 같은 부서 사람끼리 보는 심사보다 다른 경험을 가진 사람이 섞인 심사가 낯선 안건에 기회를 줄 가능성이 큽니다. 넷째, AI를 문장을 다듬는 데만 쓰지 말고 반론을 찾는 데도 쓰게 하십시오. '이 기획안이 기존 사업과 겹치는 지점을 찾아 달라'고 물으면 같은 도구가 평범함을 드러내는 쪽으로 일합니다.
쓰는 쪽에도 덧붙일 말이 있습니다. 생성형 AI는 생산적, 하지만 동기는?에서 다뤘듯 AI에 지나치게 기대면 몰입과 창의적 사고의 기회를 잃을 수 있습니다. 기획의 출발점이 되는 질문만큼은 직원이 먼저 붙잡고, AI는 그 뒤에 쓰도록 리더가 순서를 잡아 주면 좋겠습니다.
결국 이 연구가 경영진에게 던지는 질문은 하나입니다. 우리 회사의 결재 라인은 잘 쓴 문서를 고르고 있습니까, 새로운 생각을 고르고 있습니까? 지난 1년 동안 승인한 기획안을 펼쳐 놓고 그 전해의 안건과 무엇이 달랐는지 확인해 보시죠. 그 차이가 생각보다 작다면 기획서를 쓰는 직원보다 심사표를 먼저 볼 때입니다.