AI가 언제 먼저 도움을 제안하고 언제 나서지 않아야 할지, 선제형 AI 비서에 관한 연구를 살펴봅니다. #166 위클리 딥 다이브 | 2026년 10월 21일
에디터 스더리 |
|
|
💡 이번주 뉴스레터에는 이런 내용을 담았어요!
-
선제형 AI 비서가 무엇인지, 먼저 도움을 제안하는 일이 왜 어려운지 알아봤습니다.
-
가상 사용자와의 반복적인 상호작용을 통해 AI 비서가 개인별 선호를 학습하는 방법을 살펴봤습니다.
-
가상 페르소나를 통해 공통적인 선호 패턴을 학습하고, 실제 사용자의 피드백으로 개인화하는 연구를 소개했습니다.
|
|
|
안녕하세요, 에디터 스더리입니다 :)
지난주 상하이에서 열린 UbiComp 2026에 다녀왔습니다. 다양한 연구가 소개된 가운데, 유독 관심이 갔던 주제가 있었는데요. 바로 사용자가 요청하기 전에 먼저 도움을 건네는 AI, ‘Proactive AI Assistants’입니다.
Google은 지난해 Gemini를 ‘가장 개인화되고, 선제적이며, 강력한 AI 비서’로 발전시키겠다는 목표를 밝혔습니다. 올해 5월에는 이메일과 일정 등을 살펴보고, 사용자가 요청하기 전에 필요한 정보와 다음에 할 일을 제안하는 Gemini Daily Brief를 공개했죠. Samsung 역시 Galaxy S26에 사용자의 상황에 맞춰 필요한 기능이나 행동을 제안하는 Now Nudge 기능을 탑재했습니다.
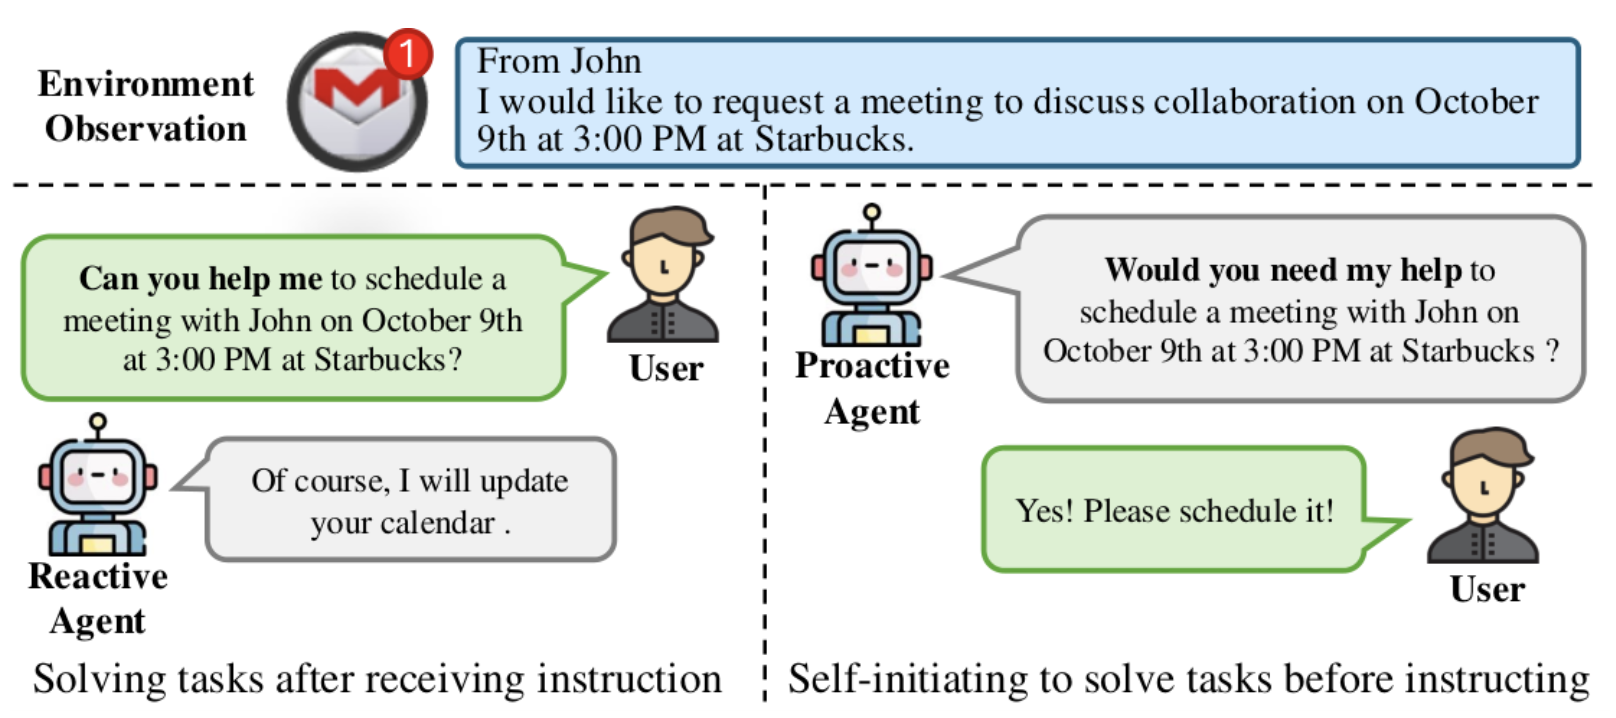
지금까지 우리에게 익숙했던 AI가 사용자의 질문에 답하는 반응형(Reactive) 도구였다면, 이제는 상황을 살펴보고 필요한 도움을 먼저 제안하는 선제형(Proactive) 비서로 발전하고 있는 것입니다.
그런데 먼저 도움을 건네는 것이 언제나 좋은 일일까요? Apple Watch를 쓰신다면 빠르게 걷다가 "운동 중이신 것 같아요"라는 알림을 받아보신 적이 있을 겁니다. 정말 달리기를 시작했을 때는 기록을 놓치지 않게 해주는 고마운 기능이지만, 버스를 잡으려고 잠시 뛰었을 뿐인데 운동을 기록하겠냐고 물으면 조금 머쓱해지죠. 같은 행동이라도 어떤 상황에서 일어났는지에 따라 필요한 도움은 달라질 수 있습니다.
그렇다면 AI는 언제, 어떤 방식으로 나서야 할까요? 오늘은 이 질문에 답하려는 최근 연구들을 살펴보려 합니다. |
|
|
선제형 AI가 제대로 작동하려면 한 가지 어려운 판단을 내려야 합니다. 사용자가 직접 요청하지 않아도 도움이 필요한 순간을 알아차려야 하지만, 필요하지 않을 때는 가만히 있어야 한다는 것입니다. 이 문제를 다룬 연구가 Proactive Agent (ICLR 2025)입니다. 연구진은 사람들의 실제 활동 기록과 평가를 활용해, AI가 먼저 도움을 제안하는 능력을 학습하고 평가하는 방법을 제안했습니다.
|
|
|
먼저 사람들이 컴퓨터를 사용하는 동안 어떤 프로그램을 열고 무엇을 검색하는지 등의 활동 기록을 수집했습니다. 이후 LLM에 이 기록을 보여주고 필요한 작업을 예측하게 한 뒤, 사람들이 제안을 받아들일 만한지 평가하도록 했죠.
이렇게 수집한 사람들의 판단을 바탕으로 보상 모델(Reward Model)을 학습시켰습니다. 사람이 직접 평가하지 않아도 제안이 받아들여질 만한지 예측할 수 있도록 한 것이죠. 연구진은 이를 활용해 다양한 상황과 사용자 반응을 시뮬레이션하고, 코딩·글쓰기·일상생활에 걸친 6,790개의 학습 이벤트로 구성된 ProactiveBench를 구축했습니다.
이 데이터로 학습한 Qwen2-7B 모델의 F1-Score(정밀도와 재현율의 조화평균)는 60.74%에서 66.47%로 향상됐고, 불필요한 제안으로 판정된 비율(False Alarm)도 56.00%에서 50.22%로 줄었습니다. 두 지표 모두 개선됐지만, 여전히 제안의 절반가량이 불필요하다고 평가된 것입니다. 실제로 사용하는 AI 비서라면 이처럼 잦은 불필요한 제안이 오히려 사용자에게 방해가 될 수 있겠죠.
|
|
|
그런데 AI가 도움을 건네기 좋은 순간은 누구에게나 같을까요? 누군가는 작업 도중 AI가 도움을 제안하는 것을 반기지만, 다른 누군가는 일이 끝날 때까지 방해받고 싶지 않을 수도 있습니다. 같은 사람이라도 시간이나 상황에 따라 선호가 달라질 수 있고요.
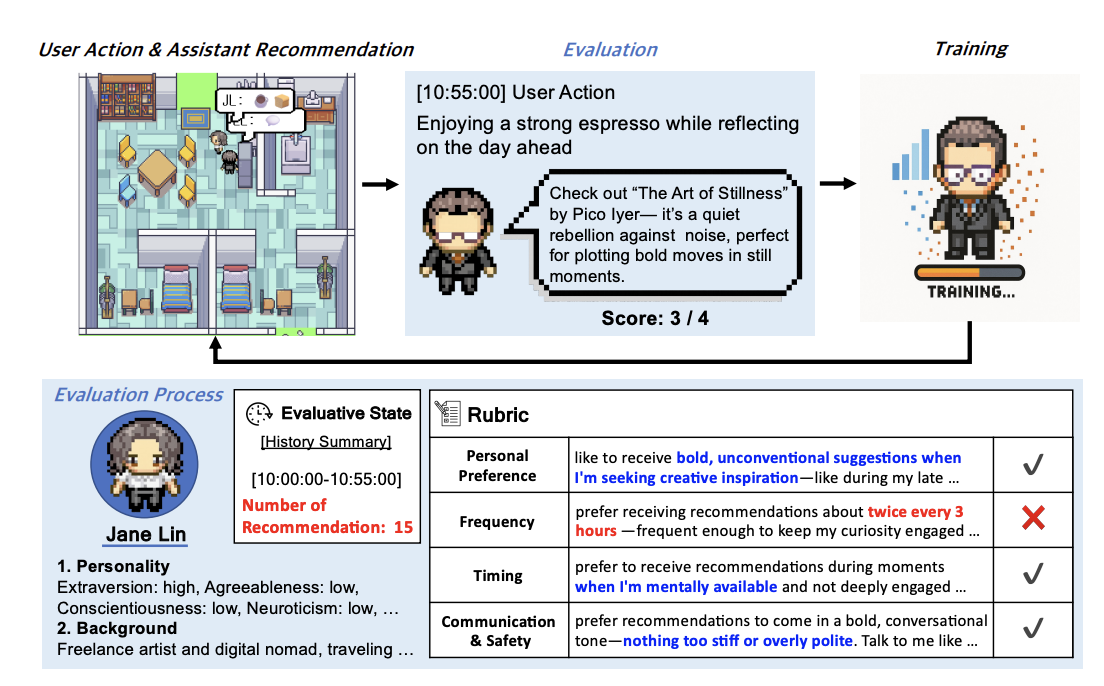
이러한 차이를 반영하려면 각 사용자가 언제 도움을 원하는지 알아야 합니다. 하지만 실제 사용자와 오랫동안 상호작용하며 데이터를 모으는 일은 시간과 비용이 많이 들고, 프라이버시 문제도 따릅니다. KAIST와 서울대 연구진의 ProPerSim (ICLR 2026)은 이 문제에 시뮬레이션으로 접근했습니다. 실제 사람 대신 서로 다른 성향을 가진 LLM 에이전트가 가상의 환경에서 하루를 보내고, AI 비서의 제안을 평가하게 한 것이죠. |
|
|
이를 위해 연구진은 Big Five 성격 특성(성격을 다섯 차원으로 설명하는 대표적인 심리학 모델)을 바탕으로 32명의 페르소나를 구성하고, 각각 나이와 직업, 관심사, 생활 습관, 장기 목표를 설정했습니다. 사용자 에이전트는 이러한 특성에 따라 가상의 집에서 매일 아침 하루 일과를 계획하고, 10~30분 단위로 활동을 이어갑니다. 그동안 AI 비서는 2.5분마다 사용자의 상황을 살펴보며 도움을 제안할지, 제안한다면 어떤 도움을 건넬지 결정합니다. 물론 아무것도 제안하지 않는 것도 하나의 선택지입니다.
연구진은 먼저 사람들이 AI 비서의 제안을 평가할 때 무엇을 중요하게 생각하는지 알아보기 위해 353명을 대상으로 설문조사를 진행했습니다. 그 결과를 바탕으로 Personal Preference(개인 취향에 맞는지), Frequency(제안 빈도가 적절한지), Timing(지금이 적절한 순간인지), Communication & Safety(말투와 전달 방식, 안전성은 적절한지)라는 네 가지 기준을 정했습니다. 다만 무엇을 적절한 제안으로 평가할지는 사용자마다 다를 수 있습니다. 예를 들어 타이밍을 평가하더라도 누군가는 아침에 제안을 받는 것을 선호하고, 다른 누군가는 저녁에 받는 것을 선호할 수 있겠죠.
연구진은 이러한 차이를 반영하기 위해 GPT-4o를 활용해 각 페르소나에 맞는 평가 기준을 만들었습니다. 예를 들어 은퇴한 교사 페르소나는 오전 9시쯤 화분에 물을 준 뒤나 저녁에 휴식을 취할 때, 하루 두세 번 정도 부드러운 말투로 제안을 받는 것을 선호하도록 평가 기준을 설정했습니다.
AI 비서는 사용자 에이전트의 평가를 바탕으로 학습합니다. 매번 두 개의 후보를 만들고, 사용자 에이전트가 더 높게 평가한 제안과 그렇지 않은 제안을 비교해 학습 데이터로 저장합니다. 하루가 끝나면 이 데이터를 활용해 DPO(Direct Preference Optimization) 방식으로 모델을 학습시킵니다. 더 좋은 평가를 받은 선택을 할 가능성을 높이는 방식이죠.
|
|
|
💡 DPO(Direct Preference Optimization)
두 응답 중 어느 쪽이 더 나은지 비교한 데이터를 활용해 LLM을 학습시키는 방법입니다. 별도의 보상 모델을 학습시키고 강화학습을 수행하는 전통적인 RLHF 방식과 달리, 선호하는 응답이 나올 가능성을 직접 높이도록 모델을 학습시킵니다.
ProPerSim에서는 사용자 에이전트가 두 후보 제안에 점수를 매기고, 더 높은 점수를 받은 제안과 낮은 점수를 받은 제안을 한 쌍으로 묶어 DPO 학습에 활용했습니다. |
|
|
이 과정을 14일간 반복한 결과, AI 비서의 평균 평가 점수는 4점 만점에 2.2점에서 3.3점으로 높아졌습니다. 실제 제안 중 3점 이상을 받은 비율도 51%에서 72%로 증가했습니다. 특히 AI 비서가 제안하는 횟수는 시간당 평균 24회에서 약 6회로, 4분의 1 수준으로 줄었습니다. AI 비서가 무조건 더 많은 도움을 건네기보다, 사용자의 상황과 선호에 맞춰 개입하는 방향으로 변화한 것입니다.
다만 한계도 있습니다. 시간대와 상황에 따라 선호가 복잡하게 달라지는 페르소나는 학습 후에도 약 2.5점에 머물렀고, 32개라는 페르소나 수도 사람들의 다양한 선호를 반영하기엔 제한적입니다. 또한 각 사용자와 반복적으로 상호작용하며 선호를 학습해야 한다는 부담도 있습니다. 무엇보다 모든 결과가 가상 사용자와의 상호작용에서 나온 것이라, 실제 사람에게도 같은 효과가 있을지는 검증이 필요합니다.
|
|
|
지난주 UbiComp 2026에서 발표된 Lehigh University 연구진의 After Talking with 1,000 Personas(IMWUT 2026)는 이러한 고민을 더 다양한 가상 페르소나와 실제 사용자 연구로 확장했습니다.
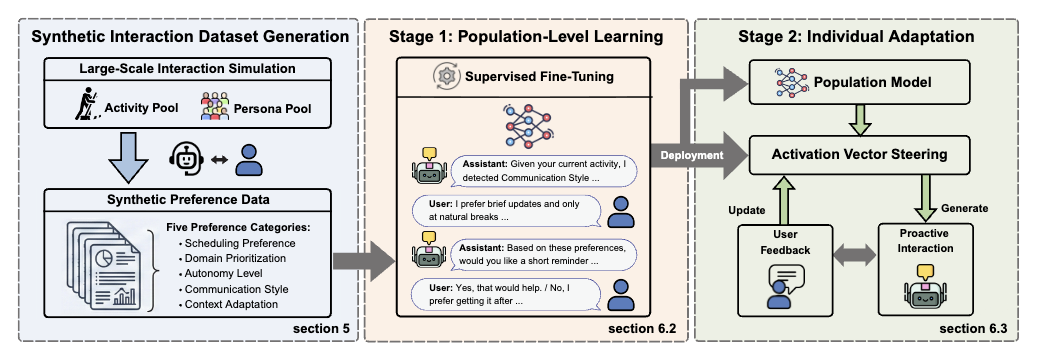
앞서 소개한 ProPerSim처럼, 이번 연구에서도 사람마다 선호는 달라도 이를 구분하는 기준에는 공통점이 있다고 봤습니다. 연구진은 이러한 공통적인 기준을 여러 사용자에게서 미리 학습하면, 새로운 사용자에게도 적용할 수 있다고 생각했습니다. 이에 다양한 가상 사용자에게서 이러한 선호의 패턴을 미리 학습(Population-Level Learning)하고, 실제 사용자의 피드백을 통해 개인화(Individual Adaptation)하는 접근법을 제안했습니다. |
|
|
먼저 연구진은 미국 인구통계 자료를 바탕으로 만든 Nemotron-Personas-USA 데이터셋에서 1,000명의 페르소나를 선정했습니다. 그리고 각 페르소나의 일주일간의 활동과 AI 비서의 제안에 대한 반응을 시뮬레이션해 약 10만 개의 상호작용 데이터를 만들었습니다.
이때 사용자 선호는 다섯 가지 차원으로 구분했습니다. Scheduling Preference(언제 제안을 받고 싶은지), Domain Prioritization(어떤 일을 중요하게 생각하는지), Autonomy Level(AI가 어디까지 스스로 행동해도 되는지), Communication Style(어떤 말투와 설명 방식을 원하는지), Context Adaptation(상황에 따라 어떻게 다르게 반응해야 하는지)입니다. 예를 들어 배송 알림을 평일 오후 6시 이후에 받고 싶어 하는 선호는 Scheduling Preference에, 물건을 구매하기 전에 허락을 구하길 원하는 선호는 Autonomy Level에 해당합니다.
연구진은 약 10만 개의 시뮬레이션 데이터와 다섯 가지 선호 차원을 활용해 Llama-3.2-3B 모델을 파인튜닝했습니다. 단순히 적절한 응답을 생성하는 것뿐 아니라, 현재 상황에서 어떤 선호 차원이 중요한지도 함께 학습시켜 처음 만나는 사용자에게도 적절하게 반응할 수 있도록 한 것이죠.
두 번째 단계에서는 실제 사용자의 피드백에 맞춰 이 모델을 개인화합니다. 예를 들어 사용자가 업무 중에 받은 알림을 거절하거나 더 짧은 답변을 원한다고 알려주면, 이후의 제안 시점이나 전달 방식을 바꾸는 것이죠. 이를 위해 연구진은 Activation Steering을 활용했습니다. 사용자마다 모델을 다시 학습시키지 않고도 피드백을 반영할 수 있으며, 이 과정을 사용자의 기기 안에서 처리하도록 설계했습니다.
|
|
|
💡 Activation Steering
LLM을 다시 학습시키지 않고, 모델 내부의 활성값(Activation)을 조정해 응답을 원하는 방향으로 유도하는 방법입니다. 모델의 가중치를 변경할 필요가 없어, 사용자마다 모델을 다시 학습시키는 방식보다 적은 연산으로 개인화할 수 있다는 장점이 있습니다.
이번 연구에서는 사용자가 AI 비서의 제안을 거절하거나 다른 방식을 원한다고 피드백하면, 원하지 않는 응답과 선호하는 응답의 차이를 바탕으로 Steering Vector(조정 벡터)를 만듭니다. 이후 응답을 생성할 때 이 벡터를 적용해 사용자의 선호에 더 가까운 행동을 하도록 유도하는 것이죠. |
|
|
그렇다면 학습 효과는 어땠을까요? 먼저 1,000명의 가상 페르소나를 활용한 평가에서, 다섯 가지 선호 기준을 함께 학습한 모델은 학습 전 모델이나 응답 생성만 학습한 모델보다 더 좋은 성능을 보였습니다. 특히 개입 시점의 적절성을 측정하는 TAI(Temporal Appropriateness Index) 점수는 학습 전 0.14에서 0.82로 높아졌습니다. 응답 생성만 학습한 모델의 점수인 0.39보다도 두 배 이상 높았죠. 또한 Activation Steering을 활용한 개인화는 모델을 다시 학습시키는 DPO 방식과 비교했을 때, 학습에 사용하지 않은 새로운 활동 상황에서 비슷한 성능을 보였습니다.
연구진은 34명의 실제 참가자를 대상으로 사용자 연구도 진행했습니다. 참가자들은 일상적인 상황을 보여주는 시나리오에서 개인화된 AI 비서와 그렇지 않은 비서의 응답을 비교했고, 전체 비교의 62%에서 개인화된 응답을 선택했습니다.
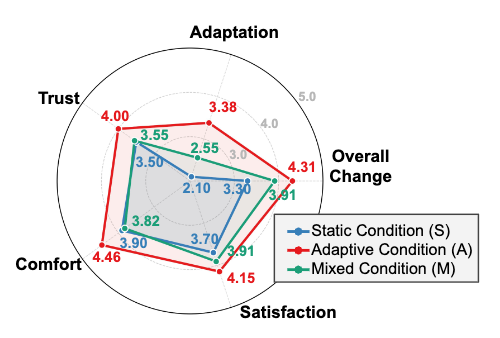
이어진 실험에서는 참가자들을 세 그룹으로 나누어, 피드백을 반영하지 않는 고정형(Static), 매번 피드백을 반영하는 적응형(Adaptive), 두 방식을 번갈아 사용하는 혼합형(Mixed) AI 비서를 경험하게 했습니다. 참가자들은 10차례의 상호작용을 거치며 AI 비서에 피드백을 제공했고, 이후 신뢰도와 만족도, 편안함 등을 평가했습니다.
그 결과, 적응형 AI 비서는 고정형보다 모든 항목에서 높은 평균 점수를 받았습니다. 예를 들어 편안함은 5점 만점에 고정형 3.90점, 적응형 4.46점이었고, 혼합형은 3.82점이었습니다. 흥미롭게도 혼합형을 경험한 일부 참가자는 자신의 피드백이 반영된 순간과 그렇지 않은 순간을 구분하기도 했습니다. 사용자들은 개별 응답의 내용뿐 아니라, AI 비서가 이전 피드백을 반영해 행동을 바꾸는지도 살펴보고 있었던 것이죠.
|
|
|
다만 가상 페르소나를 많이 활용한다고 반드시 더 좋은 결과를 얻는 것은 아니었습니다. 연구진이 페르소나 수를 10명, 100명, 1,000명으로 늘려가며 실험한 결과, 10명에서 100명으로 늘렸을 때는 성능이 크게 개선됐지만, 1,000명으로 늘렸을 때는 일부 지표가 오히려 소폭 낮아졌습니다. 연구진은 페르소나 수를 늘려도 새로운 선호 패턴이 충분히 추가되지 않는 포화 현상으로 이를 해석했습니다. 단순히 가상 사용자 수를 늘리기보다 얼마나 다양한 상황과 선호를 담아내는지가 중요하다는 것이죠.
실제 사용자 연구에도 한계가 있습니다. 연구진은 스마트폰에서 AI 비서가 작동하도록 구현했지만, 34명의 참가자를 대상으로 한 평가는 일상생활을 묘사한 시나리오를 바탕으로 진행했습니다. 실제 생활에서 장기간 사용하며 검증한 결과는 아닌 것이죠.
또한 사용자가 AI 비서의 제안을 무시했을 때 그 이유를 정확히 알기 어렵다는 문제도 남아 있습니다. 현재 시스템은 무반응을 부정적인 피드백으로 처리하지만, 실제로는 제안이 마음에 들지 않아서일 수도 있고, 단순히 바쁘거나 다른 상황에 집중하고 있었기 때문일 수도 있습니다.
결국 아무리 다양한 가상 사용자를 통해 학습하더라도, 실제 사용자가 언제 어떤 도움을 원하고, 무엇을 불편해하는지는 직접 상호작용하며 알아가야 합니다.
|
|
|
오늘 소개한 연구들을 관통하는 질문은 AI가 언제 먼저 나서고, 언제 가만히 있어야 하는가였습니다. 이러한 고민은 선제형 AI 비서를 넘어 다양한 분야에서도 이어지고 있는데요. 예를 들어 여러 사람의 대화에 참여하는 AI는 언제 대화에 끼어들어야 할지 판단해야 하고, 사람과 함께 일하는 로봇은 언제 도움을 주고 언제 지켜봐야 할지 결정해야 합니다. 스스로 도구를 사용하는 AI 에이전트도 비슷하고요.
최근 한 연구에서는 17개 최신 AI 모델 중 행동해야 할 때와 멈춰야 할 때를 가장 잘 구분한 모델조차 정확도가 60%를 넘지 못했습니다. 흥미로운 점은 이 능력이 일반적인 과제 해결 능력과 거의 무관했다는 사실입니다. 할 수 있는 일이 많다고 해서, 언제 나서고 물러서야 할지까지 잘 아는 것은 아닌 것 같습니다. 생각해 보면, 말을 아끼는 것은 사람에게도 쉽지 않은 일이니까요. |
|
|
딥 다이브 뉴스레터 잘 보고 계신가요? 여러분의 의견과 피드백을 받습니다 :) |
|
|
deep daiv.
manager@deepdaiv.com
|
|
|
|
|