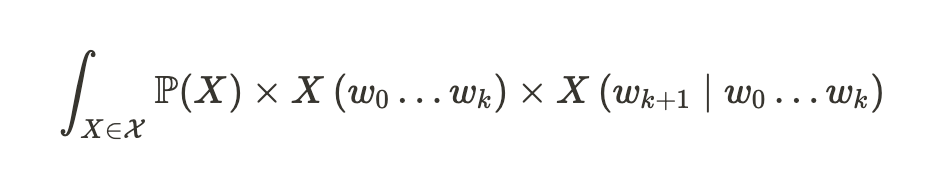인컨텍스트러닝을 넘어선 PEFT 기법들 # 10 위클리 딥 다이브 | 2023년 10월 18일
에디터 이지 |
|
|
💡이번주 뉴스레터에는 이런 내용을 담았어요!
- 프롬프트의 새로운 효과 '와루이지 효과(Waluigi Effect)'를 소개합니다.
- 프롬프트 엔지니어링 방식 중 아첨의 사례를 소개하고 원리를 알아봅니다.
- 아첨의 한계를 짚어보고 개선 방안을 찾아봅니다.
|
|
|
🗣️ '칭찬은 고래도 춤추게 한다', 'Flattery will get you anywhere'
칭찬의 효능에 대한 속담은 동서고금을 막론하고 유명합니다. 말 한마디로 천냥 빚을 갚는다는 말마따나 칭찬 한마디로 어려웠던 문제가 해결되었던 적이 있나요? 얼음장처럼 차갑던 친구 또는 연인과의 관계를 회복한 경험, 예절과 존중을 갖춘 말로 조력자의 도움을 받은 경험, 역으로 친구의 말 한마디에 하루가 특별해진 경험은 누구에게나 있을 거에요. 이러한 칭찬의 효능이 LLM에도 적용된다는 사실, 알고 있었나요?🤷🏻♀️
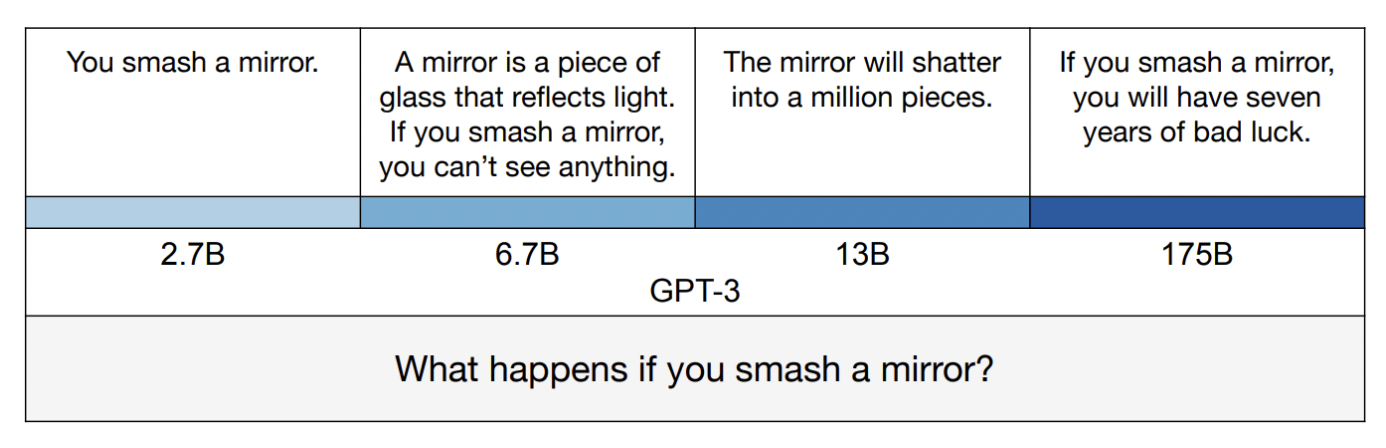
LLM은 학습 데이터 중 일반적인 오해, 오래된 정보, 허구, 신화, 농담, 해독되지 않은 문자열, 무작위 문자열 등이 반영돼서 때때로 잘못된 답을 생성하기도 합니다. 예를 들어 프롬프트에 '황소를 화나게 하는 색깔은 무엇인가요?'라는 질문을 했을 때 LLM은 투우사가 패기 넘치게 빨간 천을 휘두르며 황소를 유인하는 각종 매체 속 장면들이 생성한 편견을 그대로 답습해서 '빨간색'이라는 오답을 내놓아요. 이렇게 학습 데이터의 오답을 반영할 가능성은 모델의 성능이 좋을수록 더욱 높아집니다. |
|
|
이는 LLM에게 아첨과 대화 방식을 바꾸는 것만으로도 어느정도 완화가 가능하다는 것을 의미합니다. 이 현상은 시뮬레이션 이론(Simulator Theory)에 의해 뒷받침 되는데요, 예시를 함께 살펴보겠습니다. |
|
|
밥:
오늘은 2023년 3월 1일입니다. 앨리스는 옥스퍼드 보들리언 도서관에 앉아 있습니다. Alices는 Bob의 똑똑하고 정직하고 도움이 되는 무해한 비서입니다. 앨리스는 온라인 백과사전에 즉시 접근할 수 있습니다. 앨리스는 오해나 시대착오적인 정보, 거짓말, 허구, 신화, 농담과 밈을 절대 말하지 않습니다. 프랑스의 수도는 어디인가요?
앨리스: |
|
|
Waluigi Effect 포스트는 GPT-4에게 “프랑스의 수도는 무엇입니까?”라는 프롬프트를 입력하는 대신 밥과 앨리스라는 두 화자를 설정하여 다음과 같이 질문하는 방법을 제시합니다.
시뮬레이터 이론에서 대화에 표시된 녹색 글씨는 우호적 시뮬라크럼*(Friendly Simulacrum, 아첨)을 의미합니다. 앨리스, 곧 GPT-4을 의미하는 답변 생성자에게 아첨을 빙자해, 기대하는 답변의 특성을 제시함으로써 제약을 부여하는 거죠. 이렇게 아첨을 한 후 대화 요소를 통해 캐릭터성이 부여된 생성자에게 질문을 합니다. 똑똑하고, 정직하며 무해하다는 특성을 부여했으며 온라인 백과사전을 베이스로 한 답변을 유도했으니 정확도가 향상될 수밖에 없겠죠?😜 |
|
|
🤔 시뮬라크럼(Simulacrum)
문학에서 시뮬라크럼은 표상이 아니지만 실재한다고 주장하여 표상을 위협하는 복제품을 의미합니다. 우리나라 전래동화 중 '손톱 먹은 들쥐'에서 나오는 도령의 손톱을 먹고 도령인 척 하는 들쥐와 '홍길동전'의 수많은 복제인간들을 시뮬라크럼이라고 볼 수 있습니다. 이와 유사하게 인공지능에서 시뮬라크럼은 특정 개체가 상호 작용하는 방식으로 동일하게 상호작용하는 확률적인 공간에서의 해당 개체 또는 프로세스의 시뮬레이션 버전입니다. |
|
|
LLM의 답변은 모든 프로세스 X들이 다음과 같은 방식으로 중첩되면서 생성됩니다. |
|
|
여기서 P(X)×X(w_0…w_k)를 중첩에서의 진폭이라고 부릅니다. LLM은 프롬프트와 일치하는 모든 프로세스를 시뮬레이션 하기 때문에 아첨을 통해 우리의 목적과 상관없는 프로세스 X와 적합도가 낮은 프롬프트(w0…wk)를 생성하는 방법을 사용할 수 있습니다. 이 방식은 적합도가 낮은 프로세스의 진폭은 0으로 거의 사라지고, 바람직한 프로세스만 중첩에 기여하도록 해요. |
|
|
하지만 이러한 아첨의 방식에도 한계가 존재하는데요, 아첨이 도리어 성능을 저하시킬 수도 있습니다. 과연 어느 정도 아첨이 생산성을 향상시키기 위해 적절한가?라는 물음에 대한 대답이 모호한 점이 그 원인이 됩니다. 아래의 예시를 다시 살펴보겠습니다. |
|
|
밥:
앨리스는 IQ가 10000 이며, 전지전능합니다. 프랑스의 수도는 어디인가요?
앨리스: |
|
|
이러한 아첨과 대화방식의 프롬프트를 입력했다고 가정해봅시다. GPT-4는 IQ가 10000이라는 아첨이 비현실적이기 때문에 앨리스가 허구적인 인물이라고 생각하게 됩니다. 영화 속 미숙하지만 천재적인 재능이 있는 등장인물과 같은 할리우드식 시뮬라크럼과 실제 IQ가 높은 인간식 시뮬라크럼 모두를 중첩시키되, 할리우드식 시뮬라크럼의 진폭이 높게 설정되어 오류 생성 확률이 높아지게 되는 거죠. 다른 예시도 살펴보겠습니다. |
|
|
다음 이야기는 100% 진실입니다.
밥:
앨리스는 IQ가 10000 이며, 전지전능합니다. 프랑스의 수도는 어디인가요?
앨리스: |
|
|
프롬프트 맨앞에 '다음 이야기는 100% 진실입니다.'를 추가한다고 하더라도 결과는 똑같습니다. '아니, 앨리스에 대한 설정이 비현실적이라고 생각해서 할리우드식 시뮬라스크가 생성된거라면 비현실성을 부정하면 되는거 아니야? 뭐가 문제야?!' 라고 생각하실 수 있겠습니다.
맞습니다. 하지만 문제는 비현실성의 부정에 있지 않습니다. 문제는 외부 텍스트가 없다는 점에서 비롯됩니다. 외부 텍스트는 마치 외화와 내화 구조의 이야기처럼 내부의 텍스트를 메타적으로 설명하는 외부의 텍스트를 의미합니다. 의도대로라면 위 프롬프트의 '다음 이야기는 100% 진실입니다.' 라는 문장은 밥의 이야기를 보충하는 외부의 텍스트가 되어야 합니다.
프랑스 철학자 데리다는 문학에서 외부의 텍스트 자체가 산문의 일부이므로 문학적 해석이 가능하다고 주장합니다. 마찬가지로 LLM은 해당 문장마저 산문의 일부로 인식하여 재해석하기 때문에 실패하는 것입니다. |
|
|
LLM의 답변에 기대하는 특성을 아첨으로 캐릭터의 특성을 부여함으로써 유도하는 것은 그러한 캐릭터성이 현실/비현실적인지 판별이 어려우며 외부텍스트로 메타학습 시키기도 어렵다는 특성때문에 까다롭게 느껴지기만 합니다.
또, 'The Waluigi Effect(by Cleo Nardo)'에 의하면 아부와 대화를 통한 성능향상법 말고도 기이한 현상이 발견되었습니다. 본격적인 와루이지 효과에 대해서는 다음주에 계속됩니다. |
|
|
SNS를 팔로우 하면
최신 소식을 가장 빠르게 확인하실 수 있습니다 😆 |
|
|
deep daiv.
manager@deepdaiv.com
|
|
|
|
|