ICML2026 연구 결과 분석

LLM의 시대는 끝나는가? ICML 2026 분석


세계 3대 AI 학회 중 하나인 ICML 2026이 서울 코엑스에서 열렸고, 수천 편의 논문과 글로벌 AI 기업들이 한자리에 모였습니다. 그렇다면 지금 세계의 AI 연구자들은 LLM 다음에 무엇을 보고 있을까요? 현장에서 가장 눈에 띈 흐름은 세 가지였습니다.


여러 토큰을 동시에 만들어 AI를 더 빠르고 싸게 돌리려는 확산언어모델(DLM), 문헌조사부터 가설·실험까지 연구자의 일을 넘보는 AI 과학자, 그리고 로봇과 스마트 글래스가 현실 세계의 행동과 결과를 이해하게 만드는 월드모델입니다.


세 분야는 각각 LLM의 효율화, AI의 과학 연구 진출, 언어 밖 현실 세계로의 확장을 보여줍니다. 특히 DLM은 속도에서는 가능성을 보였지만 최고 성능 모델을 대체하기엔 아직 한계가 있고, AI 과학자는 수학에서 빠르게 발전하는 반면 실제 과학 연구에서는 연구 방향을 잡는 능력이 부족합니다. 월드모델은 인터넷 영상과 인간 행동을 학습 데이터로 바꾸려는 경쟁이 본격화되고 있습니다. ICML 2026 현장에서 보인 AI의 미래를 알려드리겠습니다.


전체 분석은 원문에 수록했습니다.

Diffusion Language Model


학회장을 돌아다니며 제가 제일 인상 깊었던 부분은 확산언어모델(Diffusion Language Model, 이하 DLM) 관련 논문이 예상보다 많다는 것이었습니다.


개인적으로 두번째 테마인 AI for Science와 세번째 테마인 월드모델은 최근의 흐름을 보면 어느 정도 예상 가능한 트렌드였거든요. 그래서 DLM을 첫번째 테마로 잡아보았습니다.


현재 LLM의 주류인 자기회귀(Autoregressive) 언어모델은 문장을 왼쪽에서 오른쪽으로 한 토큰씩 생성합니다. 반면 확산언어모델(Diffusion Language Model, 이하 DLM)은 곳곳이 빈 문장을 펼쳐 놓고 여러 빈칸을 병렬적으로 반복해 채웁니다. 사진이나 영상 생성에 쓰이는 확산 모델의 원리를 언어에 적용한 것이라고 생각하시면 됩니다.


다만 이미지 도메인에서의 확산은 연속적인 값을 기반으로 하고 언어 도메인에서의 확산은 이산적인 토큰을 기반으로 한다는 차이가 있기 때문에 완전 같은 것은 아닙니다.


DLM은 여러 위치를 동시에 처리할 수 있어 생성 속도에 유리하지만, 일반적으로 같은 규모의 자기회귀 모델보다 추론 성능이 낮은 편입니다. 저또한 개인적으로 DLM은 한때 반짝하고 묻힐만한 시도쯤으로 생각하고 있었습니다.


그런데 최근 다시 DLM의 가능성이 주목을 받고 있습니다.


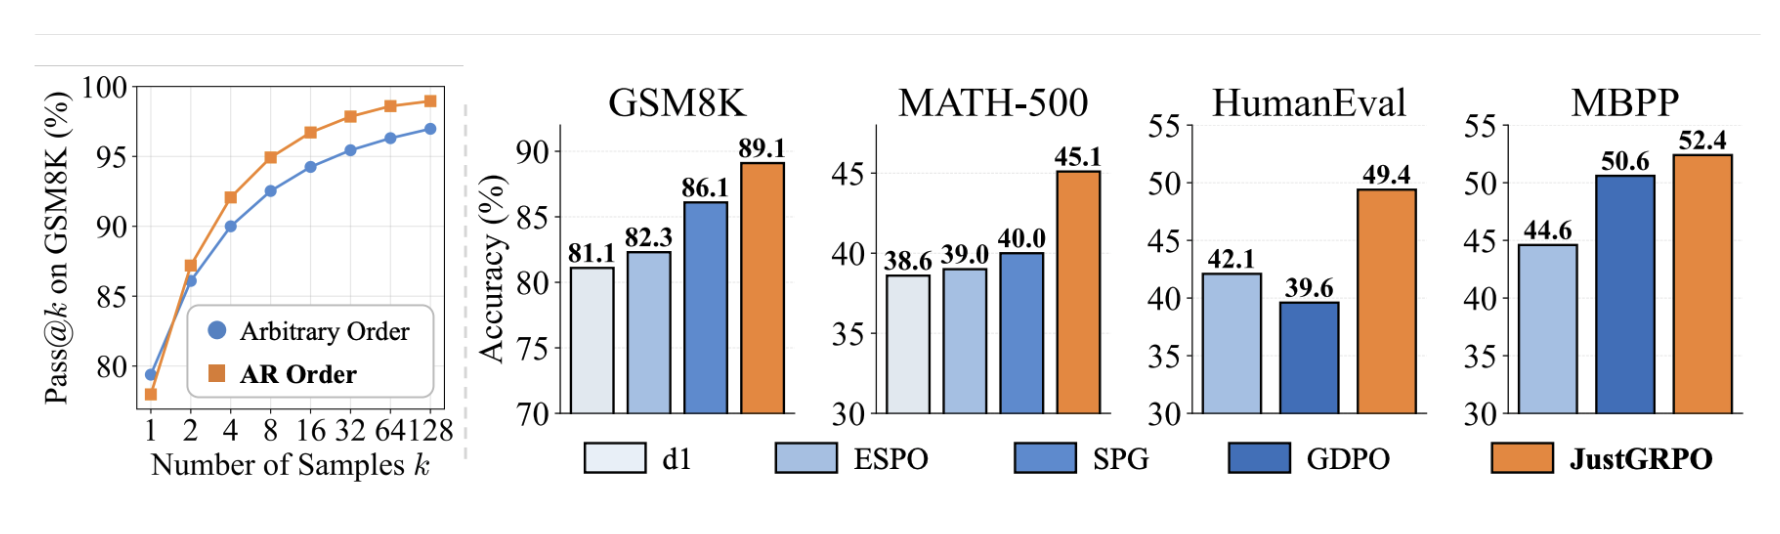
대표적으로  칭화대와 알리바바 연구진의 〈The Flexibility Trap: Why Arbitrary Order Limits Reasoning Potential in Diffusion Language Models〉는 ICML 2026 Outstanding Paper로 선정됐습니다.


이 논문은 DLM이 문장의 앞뒤를 동시에 채우는 '자유'가 오히려 추론을 방해할 수 있다고 설명합니다.[5]


자기회귀 모델은 “그러나”나 “따라서” 같은 논리적 분기점에 도달했을 때 뒤의 내용을 아직 모르므로 여러 방향을 탐색하지만, DLM은 앞뒤 문맥을 먼저 만들어 놓은 탓에 이미 정해진 흐름에 맞는 선택을 하기 쉽습니다. 연구진은 강화학습 단계에서는 왼쪽에서 오른쪽으로 전개되는 순서를 학습시키되, 실제 생성에서는 확산 방식의 병렬성을 유지했습니다.


논문 보고치로 GSM8K 정답률은 기존 방법의 최고치인 86.1%에서 89.1%로 향상됐습니다. 즉 생성은 병렬적으로 하더라도, 추론의 인과적 흐름은 순차적으로 학습하는 편이 유리할 수 있다는 결과입니다.

AI Scientist


최근들어 프론티어 AI모델들이 연구자의 영역을 무서운 속도로 침범하고 있습니다. 제가 보기에 코딩 다음으로 AI가 정복하게 될 도메인이 바로 연구의 영역인 것 같습니다.


AI 과학자는 문헌 탐색, 가설 생성, 코드 작성, 실험 실행, 결과 분석과 검증을 연결해 연구 루프를 수행하는 멀티에이전트 시스템입니다. 과학을 잘 하려면 그럴듯한 답을 많이 만드는 것으로는 부족합니다.


University of Washington, Ai2, Carnegie Mellon, MIT 연구진의 ICML 2026 Spotlight 논문 〈DR Tulu: Reinforcement Learning with Evolving Rubrics for Deep Research〉는 딥리서치 에이전트를 강화학습할 때 정답 평가 기준을 고정하지 않고, 새로 발견한 자료와 응답의 차이에 맞춰 평가 기준도 함께 진화시킵니다.


비유하자면 교사가 생각지 못한 새로운 문제 풀이 방법을 학생이 찾아오면 교사가 문제풀이의 채점 항목을 이에 맞게 보완하는 것과 비슷합니다. 논문 보고치로 8B 공개 모델은 기존 공개 딥리서치 모델보다 벤치마크 평균 15.6% 개선됐고 OpenAI Deep Research를 소폭 상회했으며, 질의당 추정 비용은 약 1,000분의 1이었습니다.


이 결과는 연구 에이전트의 성능을 높이려면 답변뿐 아니라 무엇을 좋은 답으로 평가할지에 대한 기준도 함께 학습해야 함을 의미합니다.


개인적으로 저한테 이 논문의 핵심은 낯설지 않습니다. 논문의 방법이 바로 자기 개선이라는 큰 키워드에 포함되기 때문입니다. 결국 긴 시간 동안 직접 여러 경험을 겪으면서 자기 개선을 통해 숙련되는 인간 전문가를 AI가 따라 잡으려면 AI에게도 경험으로부터 지속적으로 자기 개선이 되는 메커니즘을 달아줘야합니다.


그런데 모델의 가중치 자체를 바꾸는 학습은 비용이 비싸기 때문에 학습을 하지 않고도 자기 개선이 되는 메커니즘을 찾아내는 것이 중요하죠. 그 동안 저는 AI 에이전트의 작업 과정이나 기억을 기록해놓고 경험을 통해 그 기록을 업데이트 해나가는 종류의 자기 개선 방법을 많이 접했었는데 이 논문은 평가 방식 자체를 개선시키는 새로운 방향을 보여줍니다.


이렇게 평가방식을 지속적으로 개선해나가는 방법은 연구용 에이전트가 아니더라도 정량적인 평가가 어려운 도메인에서 유용하게 쓰일 수 있을 것 같습니다.


그외에도 다양한 연구들과 최근 주목 받는 월드모델 등은 원문으로 확인해주세요!