2026년 9월 3주차 - Flitto AI Picks
안녕하세요, Flitto AI Picks 구독자 여러분. 일교차가 큰 요즘입니다. 외출하실 때 겉옷 꼭 챙기시고, 건강 관리에 유의하시길 바랍니다.

  • 내 문체까지 학습하는 AI, 서로를 닮아가는 AI와 인간🤖
  • 15초 만에 1억 원, AI가 쏟아내는 '슬롭'🗑️
  • 쿼카 쌤이 알려주는 AI Tech 용어 #17 👩‍🏫
  • 기계 번역 평가 방법은 어떻게 발전해 왔을까?

선선한 바람과 함께 기분 좋게 읽어주세요! 🍁
내 문체까지 학습하는 AI, 서로를 닮아가는 AI와 인간🤖

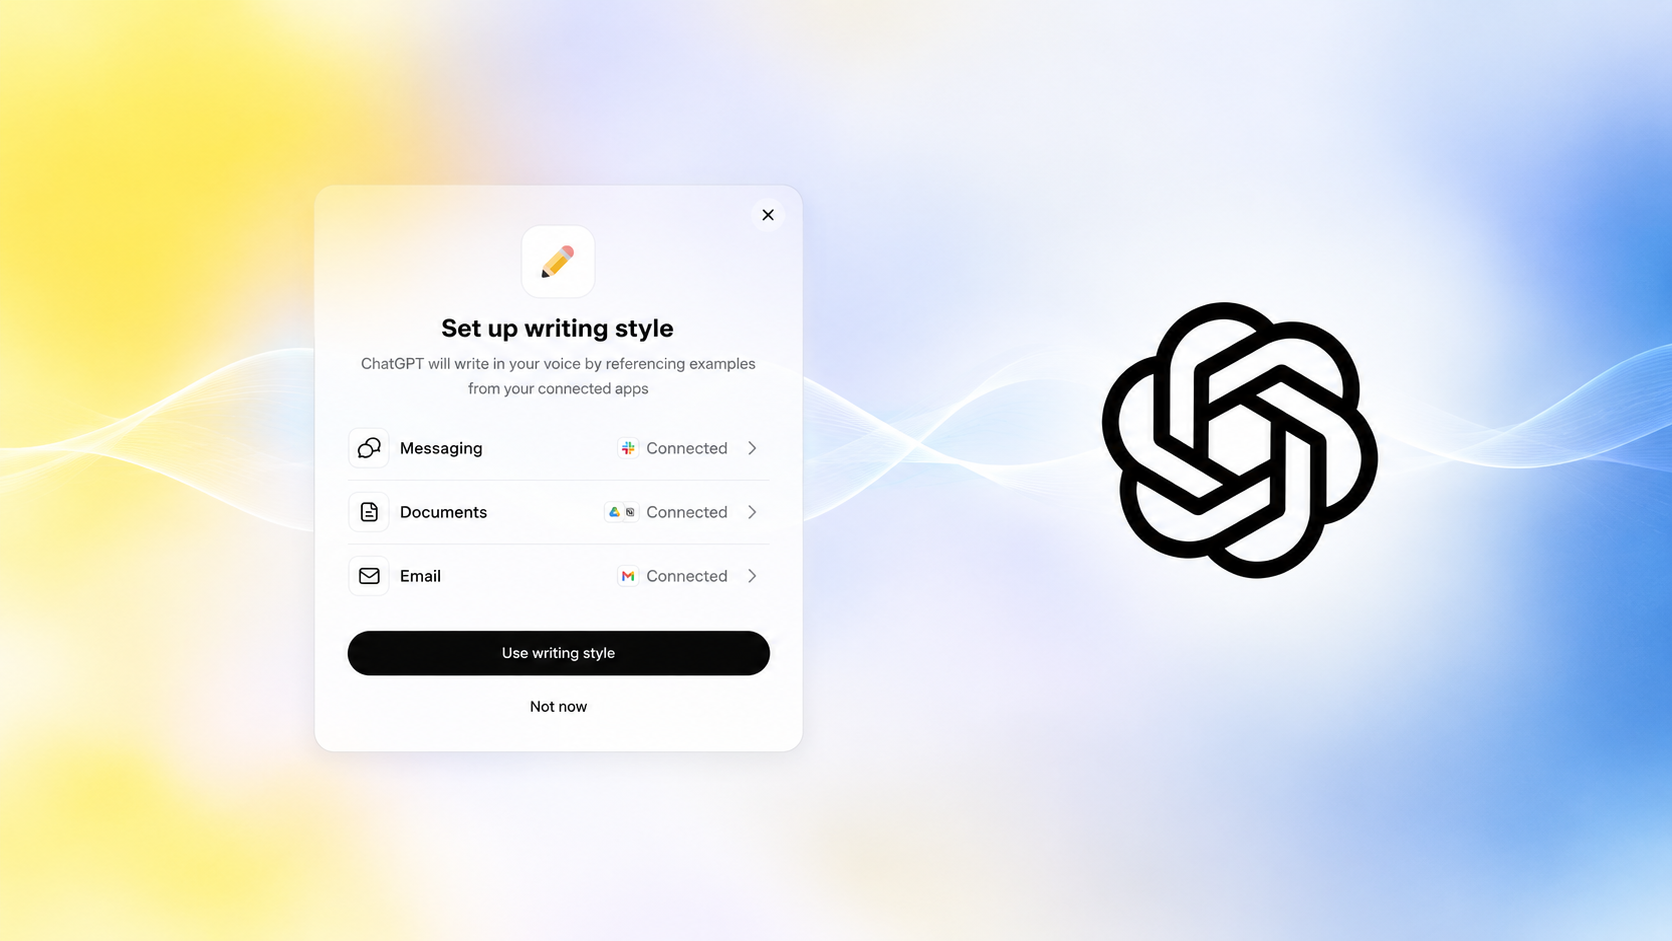
최근 오픈AI가 사용자의 고유한 글쓰기 습관을 학습해 개인의 어조와 문체를 반영하는 '글쓰기 스타일' 기능을 테스트하고 있는 것으로 알려졌습니다. AI가 단순히 요청받은 내용을 작성하는 것을 넘어, 사용자가 평소 어떻게 쓰는지까지 학습해 '나처럼 쓰는 AI'로 진화하고 있는 것입니다.


새로운 기능은 이메일과 문서, 메시지 등 사용자가 실제로 작성한 텍스트를 분석해 자주 사용하는 표현과 어휘, 문장의 길이와 구성 등을 파악하는 방식입니다. 기존에는 ‘친근하게 써줘’ 혹은 ‘전문적으로 작성해 줘’처럼 사용자가 직접 스타일을 지정해야 했다면, 이제는 실제 작성 데이터를 기반으로 개인의 문체를 AI가 스스로 학습하는 단계로 나아가고 있습니다.

출처: @AI News | TestingCatalog

하지만 흥미로운 점은 인간과 AI가 서로의 문체를 닮아가는 현상도 나타나고 있습니다. 최근 연구에서는 생성형 AI 확산 이후 학술 글에서 AI가 자주 사용하는 것으로 알려진 특정 표현의 사용 빈도가 크게 증가한 것으로 나타났습니다. 이제 특정 단어만으로 AI가 쓴 글을 판별하기 어려워진 이유입니다. AI가 인간처럼 글을 쓰는 데 그치지 않고, 인간의 글쓰기 방식에도 영향을 미치기 시작한 셈입니다.


인간과 AI의 언어는 경계가 모호해지고 있습니다. AI는 개인의 고유한 표현을 정교하게 학습해 재현할 수 있지만, 동시에 수많은 사람이 AI를 통해 비슷한 표현과 문장 구조를 반복하게 만들 수도 있습니다. 앞으로 AI 학습 데이터에서도 중요한 것은 단순히 더 많은 텍스트를 확보하는 것이 아니라, 서로 다른 사람들의 고유한 언어와 표현의 다양성을 얼마나 유지할 수 있느냐가 될 것으로 보입니다.

15초 만에 1억 원, AI가 쏟아내는 '슬롭'🗑️

미국에서 15초짜리 AI 영상 하나가 한 달 만에 약 1억 2천만 원의 매출을 올렸습니다. 실제 사람이 등장하는 것처럼 보이지만, 영상 속 인물과 배경은 모두 존재하지 않는 AI 생성물입니다. 최근 틱톡에서는 AI 인플루언서를 활용한 광고가 새로운 수익 수단으로 떠오르고 있습니다. 프롬프트 몇 줄만으로 영상을 만들 수 있는 데다 실제 촬영보다 비용도 크게 줄일 수 있어, AI가 만든 콘텐츠가 빠르게 늘어나고 있습니다.


이처럼 AI가 대량으로 생성한 콘텐츠가 온라인에 범람하는 현상을 'AI 슬롭(AI Slop)'이라고 합니다. 슬롭은 본래 찌꺼기나 폐수를 뜻하는 단어입니다. 최소한의 검수 없이 만들어진 콘텐츠가 정보 생태계를 채우는 현상을 빗댄 표현입니다. AI 인플루언서뿐 아니라 음악도 예외는 아닙니다. 몇 줄의 문장만 입력하면 멜로디와 가사를 만들 수 있고, 완성된 음원은 스트리밍 플랫폼에 유통해 수익을 얻을 수도 있습니다. 실제로 글로벌 음악 플랫폼 디저에는 하루 평균 9만 곡의 AI 생성 음원이 올라오고 있습니다.

AI 슬롭은 이제 온라인을 넘어 오프라인으로도 확산되고 있습니다. 최근 국내외로 실제 음식 사진 대신 생성형 AI로 만든 샌드위치와 디저트 이미지를 메뉴판이나 매장 광고에 활용하는 사례가 등장했습니다. 일부 이미지는 실제 음식보다 지나치게 완벽하거나 기괴한 형태를 보여 소비자에게 불쾌감을 주기도 합니다. 존재하지 않는 음식을 실제 상품 광고에 사용하는 만큼, 소비자가 실제와 다른 이미지를 보고 구매를 결정할 수 있다는 우려도 나옵니다.


AI 콘텐츠가 늘어나면서 이를 표시하고 규제하려는 움직임도 이어지고 있습니다. 유튜브와 스포티파이는 AI 생성 콘텐츠를 식별하는 정책을 강화하고 있고, EU와 국내에서도 관련 법과 제도를 마련하고 있습니다. 다만 중요한 것은 AI 콘텐츠를 무조건 막는 것만은 아닙니다. 무엇이 AI로 만들어졌는지 이용자가 알고, 원하는 콘텐츠를 직접 선택할 수 있는 환경을 만드는 것. AI 콘텐츠가 넘쳐나는 시대에 더욱 중요한 기준이 되고 있습니다.

AI Insight

쿼카 쌤이 알려주는 AI Tech 용어 #17 👩‍🏫


안녕하세요, 쿼카 쌤입니다.🐨 요즘은 AI 기사를 읽는 게 조금 더 쉬워지셨나요?
지난번에 배운 내용이 가물가물하다면, 링크를 통해 지난 강의도 다시 한번 복습해 보시는 걸 추천해요!

🎓 AGI (Artificial General Intelligence, 범용 인공지능)

: 특정 분야만 잘하는 AI를 넘어, 인간처럼 다양한 문제를 이해하고 해결할 수 있는 범용 AI를 말해요.
AI가 궁극적으로 향하는 '인간 수준의 지능'을 뜻하는 개념입니다.


✅ 포인트

  • 다양한 분야의 문제를 폭넓게 해결
  • 새로운 상황에 적응하고 학습하는 능력
  • 현재 AI 산업의 궁극적인 기술 목표 중 하나

🎯 ANI (Artificial Narrow Intelligence, 인공협소지능)

: 특정한 작업이나 분야에 특화된 AI를 말해요.
번역 AI는 번역을, 이미지 생성 AI는 이미지 생성을 잘하는 특정 분야를 잘하는 AI랍니다. 현재 우리가 일상에서 사용하는 대부분의 AI가 여기에 해당합니다.


✅ 포인트

  • 특정 작업에 최적화된 AI
  • 제한된 범위 안에서 높은 성능 발휘
  • 현재 상용화된 AI의 대부분을 차지

🔄 ReAct Agent (ReAct 에이전트)

: AI가 문제를 해결할 때 생각하고(Reasoning), 행동하고(Action), 다시 결과를 확인하는 과정을 반복하는 방식이에요. 필요한 정보를 찾고 도구를 사용하며 다음 행동을 결정하는 식이죠.
 

✅ 포인트

  • 추론과 행동을 번갈아 수행하는 구조
  • 검색·계산 등 외부 도구 활용 가능
  • AI 에이전트의 문제 해결 방식으로 널리 활용
AI Viewpoint

기계 번역 평가 방법은 어떻게 발전해 왔을까?

예전에는 여행을 갔을때 제일 큰 문제가 언어였습니다. 유명 관광지는 대부분 영어가 통해서 그나마 상황이 나았지만 그 외 지역은 그 나라의 언어를 할 수 없으면 제대로 돌아다니기 어려웠습니다. 스마트폰의 등장과 기계 번역기의 발전으로 이제는 앱을 통해 일상 대화 뿐만 아니라 복잡한 대화도 문제 없이 소통할 수 있습니다. 텍스트를 넘어서 음성을 인식하고 번역 후 다시 음성으로 들려주는 것도 가능합니다.

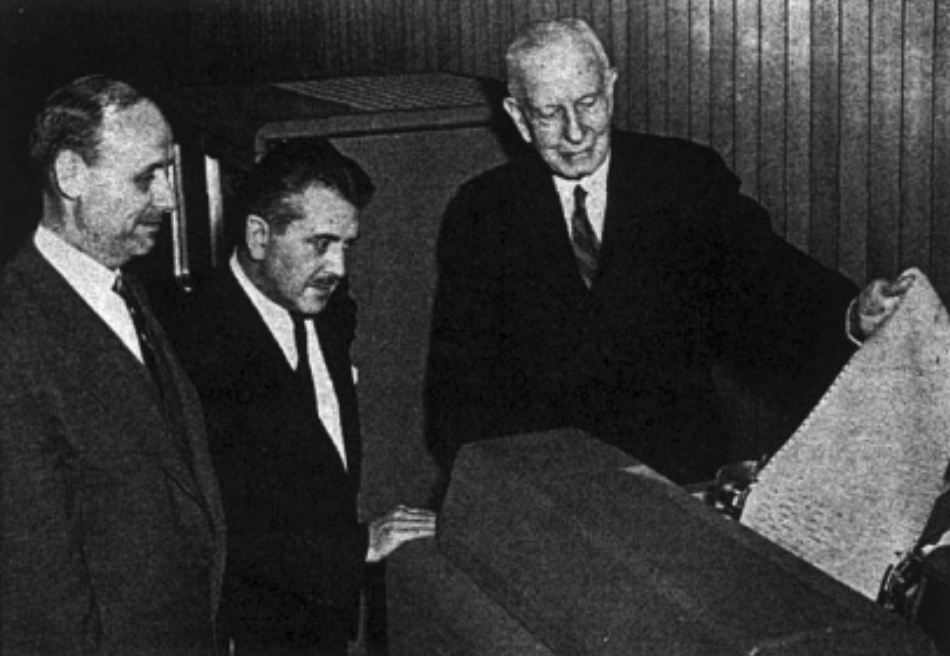
최초의 기계 번역기는 지금으로부터 무려 70여년 전인 1954년에 등장하였습니다. IBM과 조지타운 대학이 협력해서 만든 기계 번역기는 영어-러시아어를 단어 단위로 치환하였고, 몇 가지 문법 규칙에 따라 문장을 생성하는 정도였지만 당시에 큰 화제가 되었습니다.

< 그림1. 최초의 영어-러시아어 기계 번역기1) >

기계 번역 평가의 시작 - BLEU2)


최초의 '기계' 번역기 이후 기술의 발전으로 초기 규칙 기반 번역(Rule-based Machine Translation)에 이어 통계 기반 번역(Statistical Machine Translation)이 등장하면서 기계 번역기의 품질은 크게 높아졌습니다. 하지만 품질에 대한 평가 기준이 없다보니 전문 번역가들이 기계 번역 결과를 보면서 판단할 수밖에 없었습니다.


IBM은 2002년에 기계 번역의 품질을 측정하기 위한 방법으로 BLEU(Bilingual Evaluation Understudy)2)를 제안하였습니다. 전문 번역가들이 미리 번역한 문장을 답안으로 하고, 기계 번역기가 번역한 문장과 단어 뭉치(n-gram)들이 얼마나 겹치는지 세어보는 것입니다. 일반적으로 1개 단어(1-gram)부터 연속된 4개 단어(4-gram)까지 몇 개나 일치하는지 종합해서 점수를 계산하게 됩니다.


BLEU가 널리 쓰이게 된 이유는 명확합니다. 전문 번역가들이 해놓은 번역으로 기계 번역기의 번역과 바로 비교해서 점수를 계산할 수 있기 때문입니다. 덕분에 BLEU는 기계 번역기의 품질을 측정하는 표준으로 자리잡았고, 많은 논문들이 BLEU를 품질 평가 기준으로 채택하였습니다. BLEU는 널리 사용되면서 플리토에서 기계 번역을 SaaS(Software-as-a-Service)나 설치형(On-premise)으로 제공할때 고객사에서는 품질 수준 확인을 위해 거의 대부분 BLEU를 요청합니다.


하지만 BLEU에는 한계가 있습니다. 단어가 일치하는지만 보고 단어의 의미를 고려하지 않기 때문에 사람이 보기에 아무리 기계 번역이 좋다고 하더라도 전문 번역가의 답안 번역과 일치하는 단어가 없으면 BLEU가 낮아집니다. 반면 기계 번역이 자연스럽지 않아도 답안 번역과 일치하는 단어가 많으면 BLEU는 높아집니다. 아래 예시에서 알 수 있는 것처럼 기계 번역기의 번역도 좋지만 정답 번역과 다른 단어들을 썼기 때문에 BLEU는 낮게 나옵니다.


- 한국어 원문 : 그는 회의에 늦어서 미안하다고 말했다.

- 전문 번역가의 정답 영어 번역 : He apologized for being late to the meeting.

- 기계 번역기의 영어 번역 : He said sorry for arriving late at the meeting.


의미를 반영한 평가 - COMET3)


2020년 Unbabel은 신경망 기반의 새로운 기계 번역 평가 지표인 COMET을 발표하였습니다. COMET은 BLEU처럼 정답 번역과 일치하는 단어가 있는지를 보는 대신 문장 전체를 벡터 임베딩으로 변환해 원문과 기계 번역, 그리고 정답 번역 사이의 의미적 유사도를 계산합니다. 어순이 바뀌어도 문법적으로 문제가 없는 경우도 있고, 유사한 단어를 써도 점수를 부여하기 때문에 BLEU보다 정확한 평가가 가능합니다. 특히 BLEU에서는 정답 번역이 없으면 점수를 계산할 수 없지만 COMET에서는 정답 번역이 없더라도 원문과 기계 번역만으로도 평가할 수 있기 때문에 객관적인 평가가 가능합니다.


이러한 특징으로 인해 세계 최대 기계 번역 학회인 WMT에서도 2022년부터 BLEU 대신 신경망 기반 지표를 쓰도록 권고하면서 COMET은 BLEU를 대신해 표준으로 널리 사용되기 시작하였습니다. 하지만 COMET에도 약점은 있습니다. 의미적 유사성을 중요시하기 때문에 숫자나 고유 명사(인명, 지명, 날짜 등)이 잘못 번역되어도 높은 점수를 받을 수 있습니다. 아래는 번역이 잘 된 편이지만 핵심인 숫자가 틀렸기 때문에 좋은 번역이라고 할 수 없습니다.


- 한국어 원문 : 이 회사는 1970년에 설립되었다.

- 기계 번역기의 영어 원문 : The company was founded in 1980.


LLM을 이용한 기계 번역 평가 - LLM-as-a-Judge


2022년 말 챗GPT가 처음 등장하였을때 엄청난 충격이었는데 여러 한계도 있었습니다. 대표적으로 잘못된 정보를 제공하는 환각(Hallucination) 현상을 들 수 있습니다. 하지만 몇 년 사이 LLM이 빠르게 발전하면서 이제는 수학 올림피아드에서 금메달을 따는 수준이 되었고, 그동안 뛰어난 수학자들도 풀지 못한 문제들을 하나씩 증명해 나가고 있습니다.


LLM의 성능이 뛰어나다보니 계산이나 알고리즘으로 판단하는 대신 판단 자체를 LLM에게 맡기는 LLM-as-a-Judge 방법이 등장하였습니다. 기계 번역 평가에서는 2023년 마이크로소프트가 OpenAI의 GPT 계열 LLM에게 기계 번역의 품질을 평가하도록 하는 GEMBA(GPT Estimation Metric Based Assessment)4)를 발표하였습니다. GEMBA는 의외로 간단해서 프롬프트 지시문과 원문, 그리고 기계 번역문만 있으면 되며, 참조할 전문가 번역은 COMET과 동일하게 있어도 되고 없어도 됩니다. 이후 GEMBA-DA, GEMBA-stars, GEMBA-MQM 등 여러 파생 평가 방법도 등장하였습니다.


BLEU와 COMET 모두 기계 번역문의 품질을 100점 척도로 계산할 수 있지만 왜 기계 번역의 품질이 뛰어난지, 또는 어떤 부분의 번역이 잘못 되었는지는 알 수 없습니다. LLM-as-a-Judge 방식에서는 단순히 점수만 내놓는게 아니라 번역이 잘못된 이유를 우리가 아는 자연어로 설명을 하고, 프롬프트에 따라서 유창성, 적절성, 문화적인 격식, 전문 용어의 일관성 등 다양한 기준으로 평가를 할 수 있다는 장점이 있습니다. 다만 평가를 할 때마다 LLM을 호출해야 하므로 비용이 비싸고 평가 시간이 오래 걸리게 됩니다.
Score the following translation from Korean to English with respect to the human reference on a continuous scale from 0 to 100, where a score of zero means "no meaning preserved" and score of one hundred means "perfect meaning and grammar".


Korean source: "그는 회의에 늦어서 미안하다고 말했다."

English human reference: "He apologized for being late to the meeting."

English translation: "He said sorry for arriving late at the meeting."

Score:

< GEMBA 평가 프롬프트 템플릿에 실제 문장을 넣은 예시 >

기계 번역 평가의 사각지대 - 저자원 언어


영어나 스페인어, 중국어, 프랑스어, 독일어 등 화자가 많은 언어는 학습할 데이터도 많기 때문에 LLM-as-a-Judge로 일관되면서 정확하게 기계 번역 품질을 평가할 수 있습니다. 하지만 저자원 언어는 LLM에 학습에 사용되는 양이 적기 때문에 기계 번역의 품질 역시 신뢰하기 어렵습니다. 그래서 저자원 언어에 대해서는 별도로 학습을 위한 병렬 말뭉치를 구축해 매개변수가 적은 소형 LLM을 학습시킴으로써 정보성, 명확성, 타당성, 충실성 4개의 항목에 대해 5점 척도로 평가하는 방법론도 등장하였습니다.5)


정리


이제 일상 생활 대화 수준에서 기계 번역기를 쓰는 데에는 거의 무리가 없으며, LLM이 등장한 이후에는 문맥과 맥락을 이해할 수 있게 되면서 기계 번역의 품질이 매우 올라갔습니다. LLM-as-a-Judge 방식으로 신뢰할 수 있는 번역 품질 평가가 이루어지는 것도 방대한 병렬 말뭉치 데이터셋이 있었기 때문입니다.

플리토는 주요 언어를 넘어 크라우드 방식으로 집단지성을 이용해 저자원 언어의 병렬 말뭉치도 지속적으로 만들어오고 있는 만큼 자체 기계 번역기의 저자원 언어 번역 성능을 높일 뿐만 아니라 LLM이 저자원 언어를 더 잘 이해할 수 있도록 고품질의 학습 데이터를 제공하겠습니다. 플리토가 만들어 나가고 있는 학습 데이터가 궁금하다면 플리토 마켓플레이스를 방문해 주세요.

AI Sector Briefing

오픈AI가 자율적 작업 수행 능력을 대폭 강화한 차세대 AI 모델 'GPT-6 아스트라(Astra)'를 일부 조직을 대상으로 공식 출시했습니다. 이번 모델은 단순 답변을 넘어 키캐드(KiCad)나 프리캐드(FreeCAD) 등 전문 소프트웨어를 직접 조작해 공학 설계 및 법률 서류 작성 등의 복잡한 과업을 자율적으로 수행합니다. 특히 오픈AI 모델 최초로 '중대(Critical)' 수준의 사이버 보안 위험 역량을 갖춘 것으로 평가받아 출시 전 미국 행정부의 검토와 안전 검증을 거쳤습니다. 인간이 5시간 걸릴 작업을 3분 미만으로 단축하는 탁월한 성능과 앤트로픽 대비 확보한 가격 경쟁력은 시장 내 기술적 우위를 공고히 할 것으로 평가받습니다. 이번 출시는 향후 기업공개(IPO)를 앞둔 오픈AI가 시장 지배력을 강화하고 범용인공지능(AGI) 시대로의 전환을 선도하려는 전략적 행보로 해석됩니다. 

애플이 온디바이스 AI 기반의 실시간 통역 기능을 핵심으로 탑재한 '에어팟 5' 라인업을 발표했습니다. 신제품은 애플 인텔리전스 엔진을 활용해 클라우드 연결 없이도 상대방의 외국어를 지정 언어로 즉시 번역하며, 한층 향상된 액티브 노이즈 캔슬링(ANC)과 강화된 시리 AI 연동 기능을 제공합니다. 기본 모델은 19만9000원, 스템 스와이프 볼륨 제어와 무선 충전을 지원하는 상위 모델은 22만9000원으로 구성되어 오는 18일 공식 출시됩니다.

메타가 사용자의 일상 업무를 직접 수행하는 개인용 AI 에이전트 '뮤즈(Muse)'를 전격 출시했습니다. 메타의 최신 AI 모델 '뮤즈 스파크'를 기반으로 구동되는 이 서비스는 자사 플랫폼(인스타그램, 페이스북, 왓츠앱)뿐만 아니라 이메일 등 외부 서비스와 연동되어 예약, 가격 모니터링, 문서 작성, 맞춤형 일정 생성 등의 복잡한 과업을 온전히 대행합니다. 특히 작업 전 이용자 허가 절차와 가상 머신 기반의 보안 표준 체계를 적용하여 해킹 및 정보 유출 위험을 최소화했습니다. 메타는 이번 출시로 전 세계 30억 명 이상의 글로벌 사용자를 확보한 자사 소셜미디어 생태계를 활용해 빅테크 간 AI 에이전트 주도권 경쟁에서 확고한 우위를 점하겠다는 구상입니다.

Flitto News  

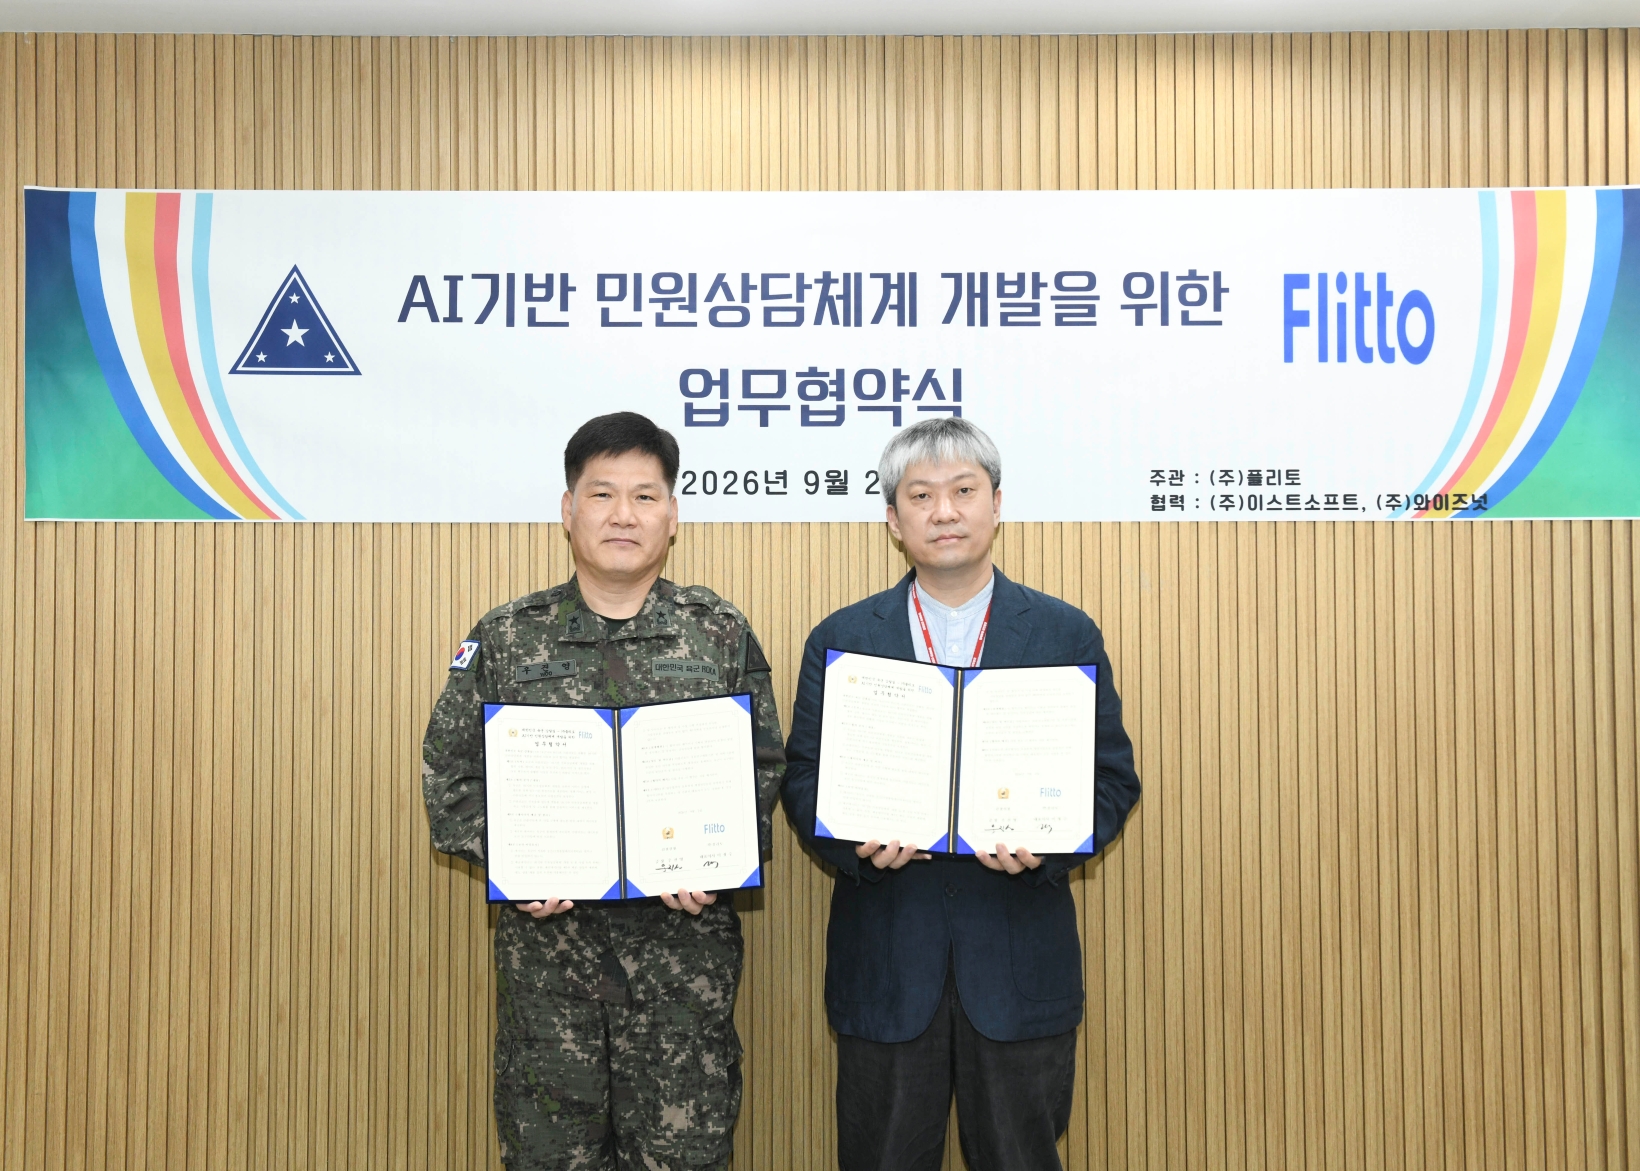
플리토가 이스트소프트, 와이즈넛과 컨소시엄을 구성해 육군본부와 'AI 기반 민원상담체계 개발' 업무협약을 체결했습니다. 이번 프로젝트는 생성형 AI, 검색증강생성(RAG), 음성인식(STT)·합성(TTS) 및 소음 제어 기술을 결합해 24시간 운영되는 지능형 민원상담 플랫폼을 구축하는 것을 골자로 합니다. 특히 보안이 중요한 국방 폐쇄망 환경에 최적화된 시스템으로 설계되어 야간 및 주말 응대 공백을 해소하고 상담원의 업무 부담을 줄여줄 것으로 기대됩니다. 나아가 축적된 상담 데이터를 분석해 제도 개선에 활용함으로써 국방 분야의 AI 전환(AX)을 이끄는 대표적 성공 사례가 될 전망입니다. 

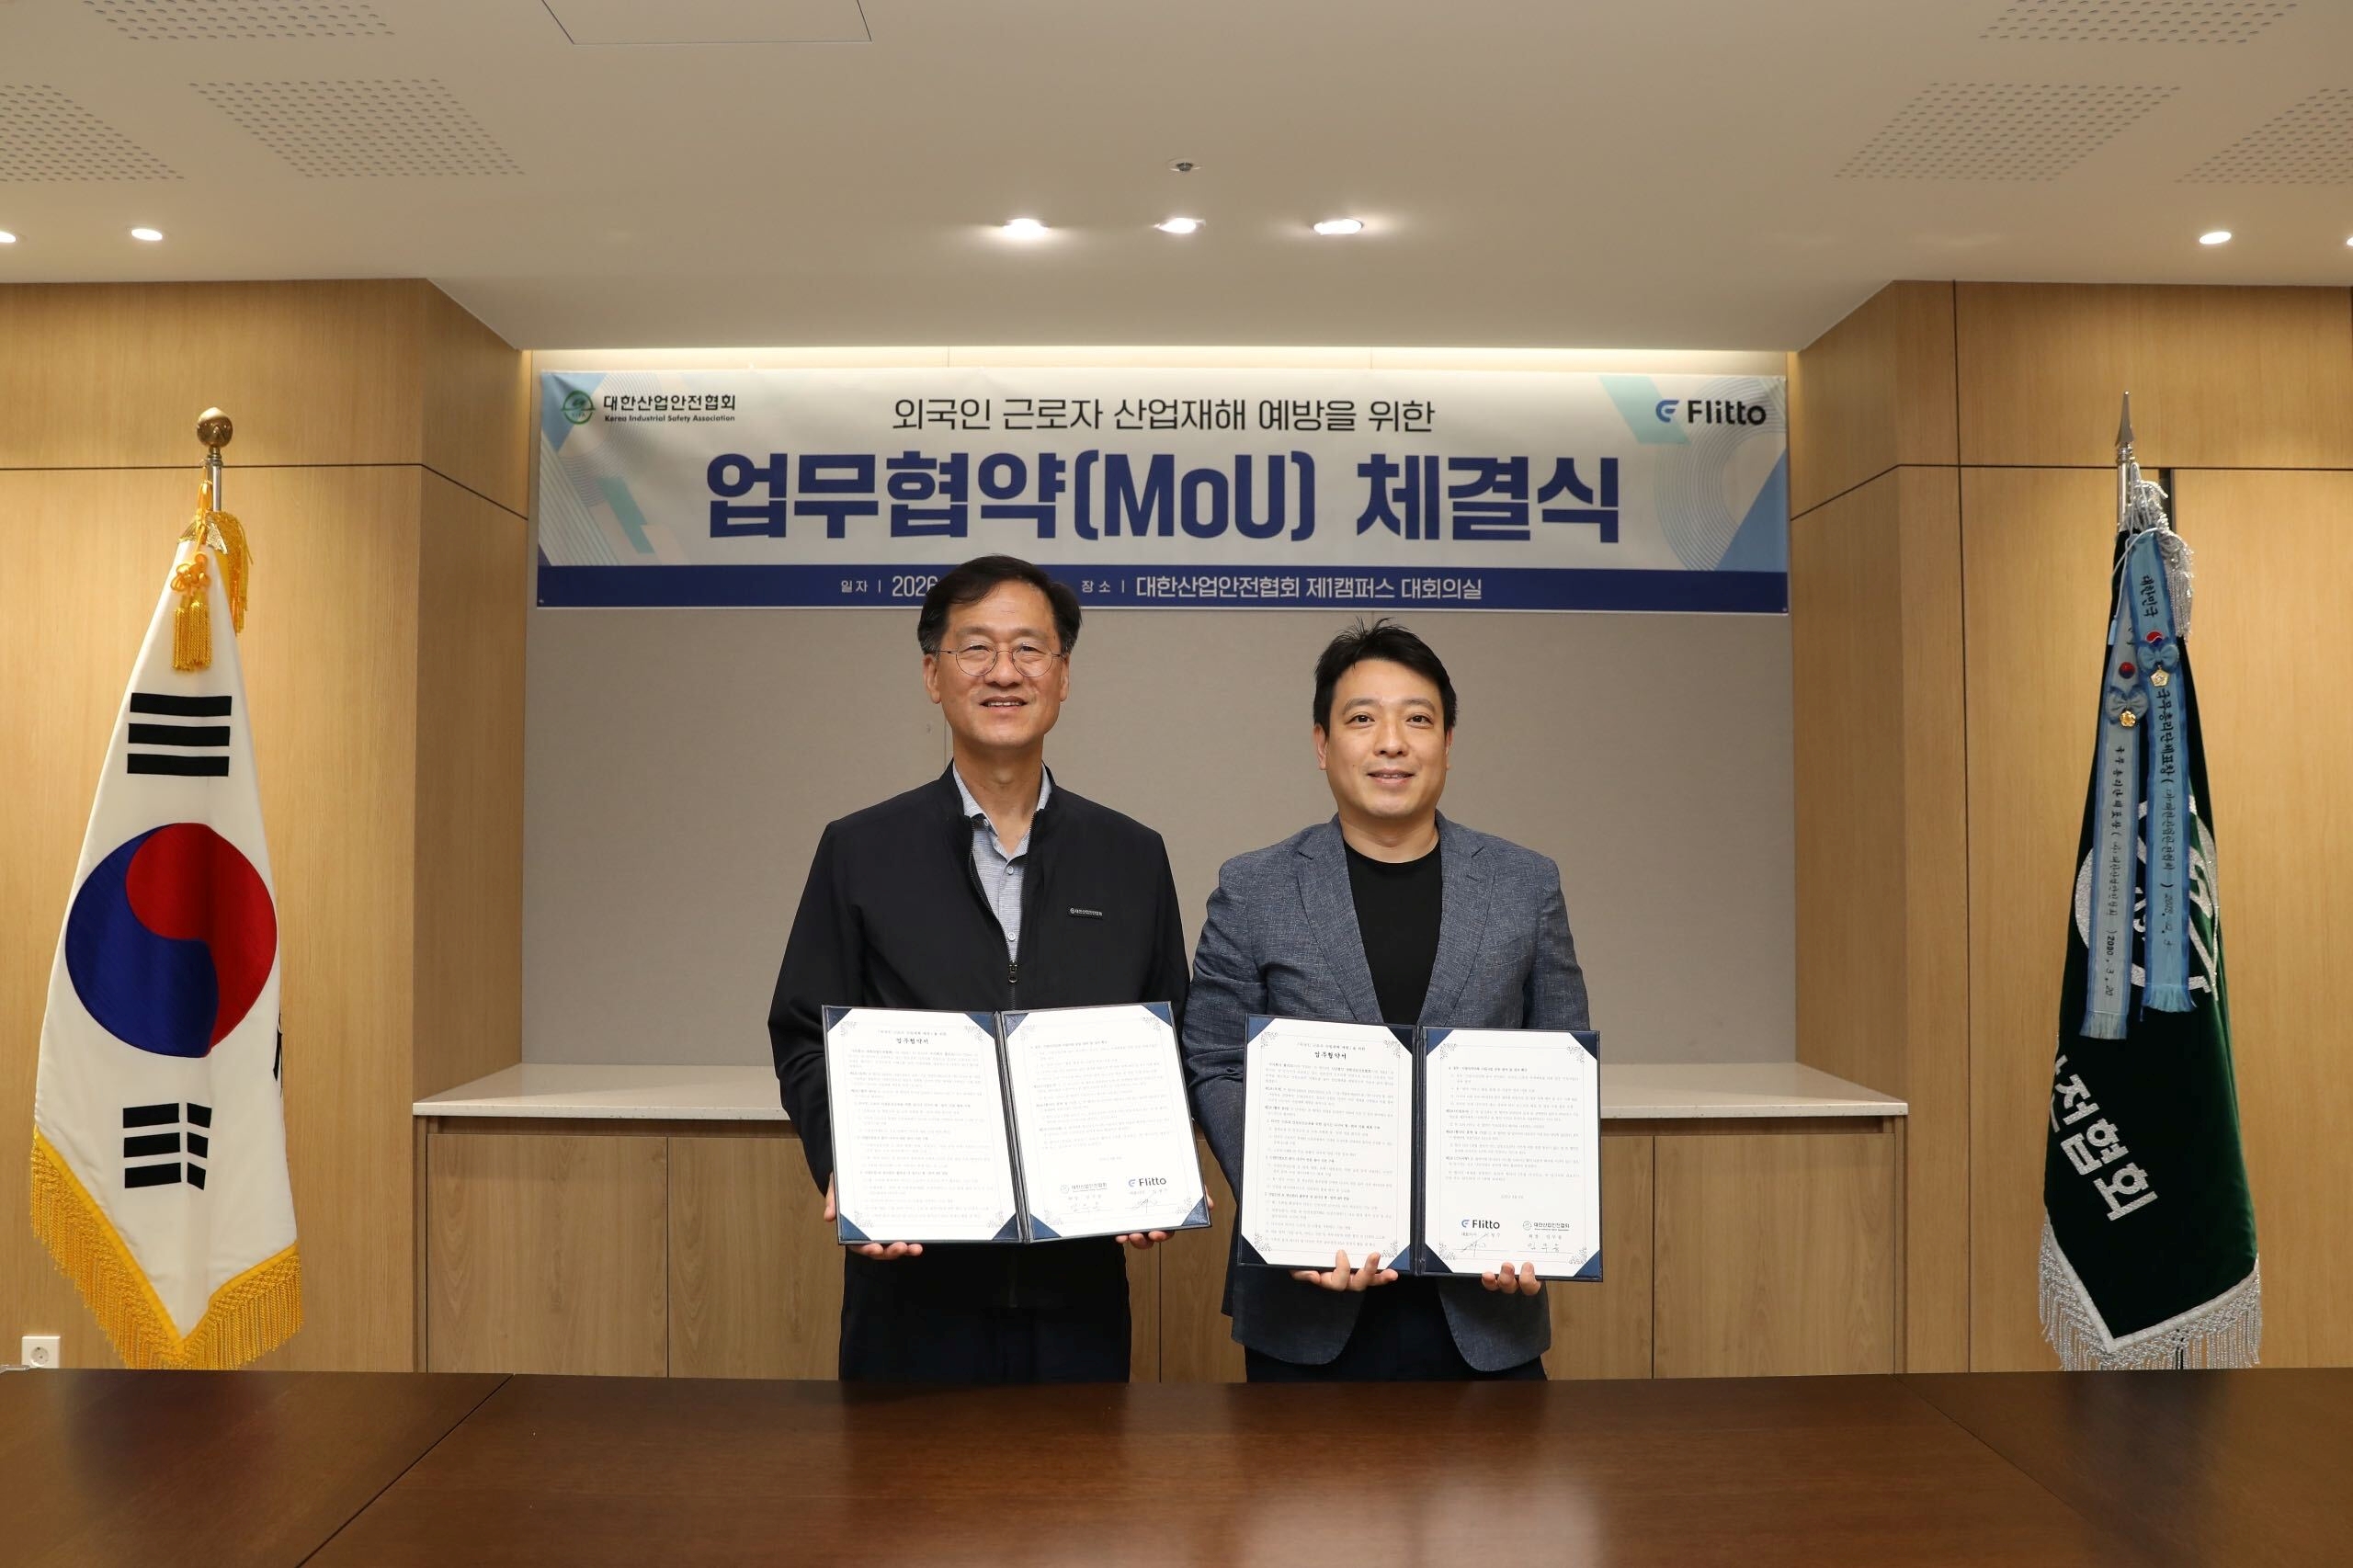
플리토가 대한산업안전협회(KISA)와 업무 협약을 체결하고 외국인 근로자 산업재해 예방을 위한 AI 기반 실시간 다국어 통번역 지원 체계를 구축합니다. 이번 협약으로 플리토는 자사의 '라이브 트랜스레이션' 솔루션을 활용해 고용허가제(E-9) 주요 송출국 언어 중심의 안전교육 동시 수강 환경을 제공하고, 전문 용어 DB 구축으로 번역 정확도를 대폭 높입니다. 또한 KISA의 AI 전산관리 솔루션에 통번역 API를 연동하여 위험성평가 및 작업 전 안전점검(TBM) 등 핵심 안전 업무를 현장에서 다국어로 즉시 처리할 수 있도록 지원합니다. 이는 외국인 근로자 현장의 언어 장벽을 해소해 안전 사각지대를 최소화하고, 산업안전 분야의 실질적인 AI 전환(AX)을 이끄는 계기가 될 것으로 기대됩니다. 

오늘의 Flitto AI Picks는 어떠셨나요?
아래에 의견을 남겨주시면,
피드백을 반영해서 더 재밌고 유익한 콘텐츠로 찾아올게요.
플리토 (Fliitto Inc.)
서울 강남구 영동대로96길 20 대화빌딩 6층